Calculateur de tokens IA : tokens et coût de l'API par modèle
Un token est le petit morceau de texte qu'un modèle d'IA lit et facture, souvent une partie de mot. Lors de notre test du 28 octobre 2026, Claude a utilisé un token pour 3,2 caractères d'anglais et le tokenizer d'OpenAI un pour 4,9 ; en français, un pour 2,5 et 4,5. Collez votre texte ci-dessous pour voir le décompte et le coût de l'API sur chaque modèle.
Mis à jour
Calculateur de tokens
Fonctionne dans votre navigateur. Rien de ce que vous collez ne quitte cette page, et notre mesure d'audience est réglée pour masquer cet outil. Le seul téléchargement est le tokenizer d'OpenAI (environ 1 Mo), depuis notre site, une seule fois.
Collez un texte ou indiquez un nombre de mots pour voir les tokens et le coût.
Comment ce calculateur de tokens compte-t-il les tokens ?
Chaque entreprise d'IA découpe le texte à sa façon, si bien que le même paragraphe donne un nombre de tokens différent sur chaque modèle. Ce calculateur utilise la meilleure méthode que chaque entreprise permet et indique, pour chaque nombre, celle qu'il a suivie.
- Modèles OpenAI : décompte exact. En tant que calculateur de tokens OpenAI, il exécute dans votre navigateur le tokenizer o200k_base d'OpenAI, avec la bibliothèque open source gpt-tokenizer (version 4.0.0). La bibliothèque de tokenisation d'OpenAI elle-même, tiktoken, associe o200k_base à GPT-4o, GPT-4.1 et à tous les modèles GPT-5.
- Modèles GPT-6 : le même tokenizer, sans confirmation. tiktoken n'a pas d'entrée pour GPT-6 au 28 octobre 2026, et OpenAI n'a pas dit quel tokenizer GPT-6 utilise. Une comparaison publique sur 31 textes, menée le 26 septembre 2026, a trouvé que GPT-6 Astra, Sol et Luna renvoient exactement les mêmes décomptes d'entrée que GPT-5.5 ; nous les comptons donc avec o200k_base et le signalons.
- Modèles Claude : notre estimation mesurée. Anthropic ne propose pas de tokenizer utilisable hors ligne, donc le calculateur de tokens Claude divise vos caractères par le ratio que nous avons mesuré pour ce type de texte (tableau ci-dessous). La page de tarifs d'Anthropic indique que les modèles Claude 4.7 et suivants partagent un tokenizer plus récent, et dans notre test Haiku 5.5, Sonnet 5.5 et Opus 5.5 sont restés à 4 tokens d'écart au plus.
- Modèles Gemini : la règle de Google. En tant que calculateur de tokens Gemini, il applique la règle approximative de Google : environ 4 caractères par token. Nous n'avons pas mesuré Gemini, car il faut pour cela une clé d'API Google.
- Autres modèles (Grok, DeepSeek, Qwen, Mistral, Kimi et les autres) : aucun tokenizer pour eux ne tourne dans le navigateur, donc le calculateur affiche le décompte OpenAI comme substitut et le signale.
Comment nous avons mesuré Claude
Le 28 octobre 2026, nous avons envoyé six textes à Claude Haiku 5.5 via Claude Code 2.1.303, depuis un dossier vide et avec tous les outils désactivés, puis relevé les tokens d'entrée dans sa sortie JSON. La même requête sans le texte (une consigne fixe d'une ligne) faisait environ 4 008 tokens, mesurés quatre fois ; en la soustrayant, il reste les tokens du texte lui-même. Le texte anglais et le code ont tourné deux fois, à 5 tokens d'écart au plus, et Claude Sonnet 5.5 et Opus 5.5 ont reçu ces deux textes en contrôle.
| Type de texte | Caractères | Tokens Claude | Caractères par token Claude | Tokens OpenAI | Caractères par token OpenAI | Claude par rapport à OpenAI |
|---|---|---|---|---|---|---|
| Texte en anglais | 1 318 | 410 | 3,21 | 268 | 4,92 | 1,53x |
| Texte en espagnol | 1 465 | 558,5 | 2,62 | 324 | 4,52 | 1,72x |
| Texte en portugais | 1 463 | 577,5 | 2,53 | 324 | 4,52 | 1,78x |
| Texte en français | 1 536 | 603,5 | 2,55 | 341 | 4,5 | 1,77x |
| Code | 1 662 | 750 | 2,22 | 521 | 3,19 | 1,44x |
| Tableau ou données | 766 | 499,5 | 1,53 | 390 | 1,96 | 1,28x |
Claude a eu besoin de 1,28 à 1,78 fois les tokens d'OpenAI pour le même texte : l'écart le plus faible pour le tableau, le plus fort pour le portugais. Cela concorde avec la comparaison publique ci-dessus, où Claude Opus 5.5 comptait 53,9 % de tokens de plus que GPT-5.5 sur ses 31 textes. Un échantillon par type de texte donne un ordre de grandeur, pas une garantie : pour un décompte exact sur Claude, l'endpoint de comptage de tokens d'Anthropic est gratuit avec une clé d'API.
Rien de ce que vous collez ne quitte la page. Le comptage et le calcul du coût se font dans votre navigateur, l'outil est masqué pour notre mesure d'audience, et le seul fichier téléchargé est le tokenizer d'OpenAI (environ 1 Mo), depuis notre propre site.
Que montre le calculateur ?
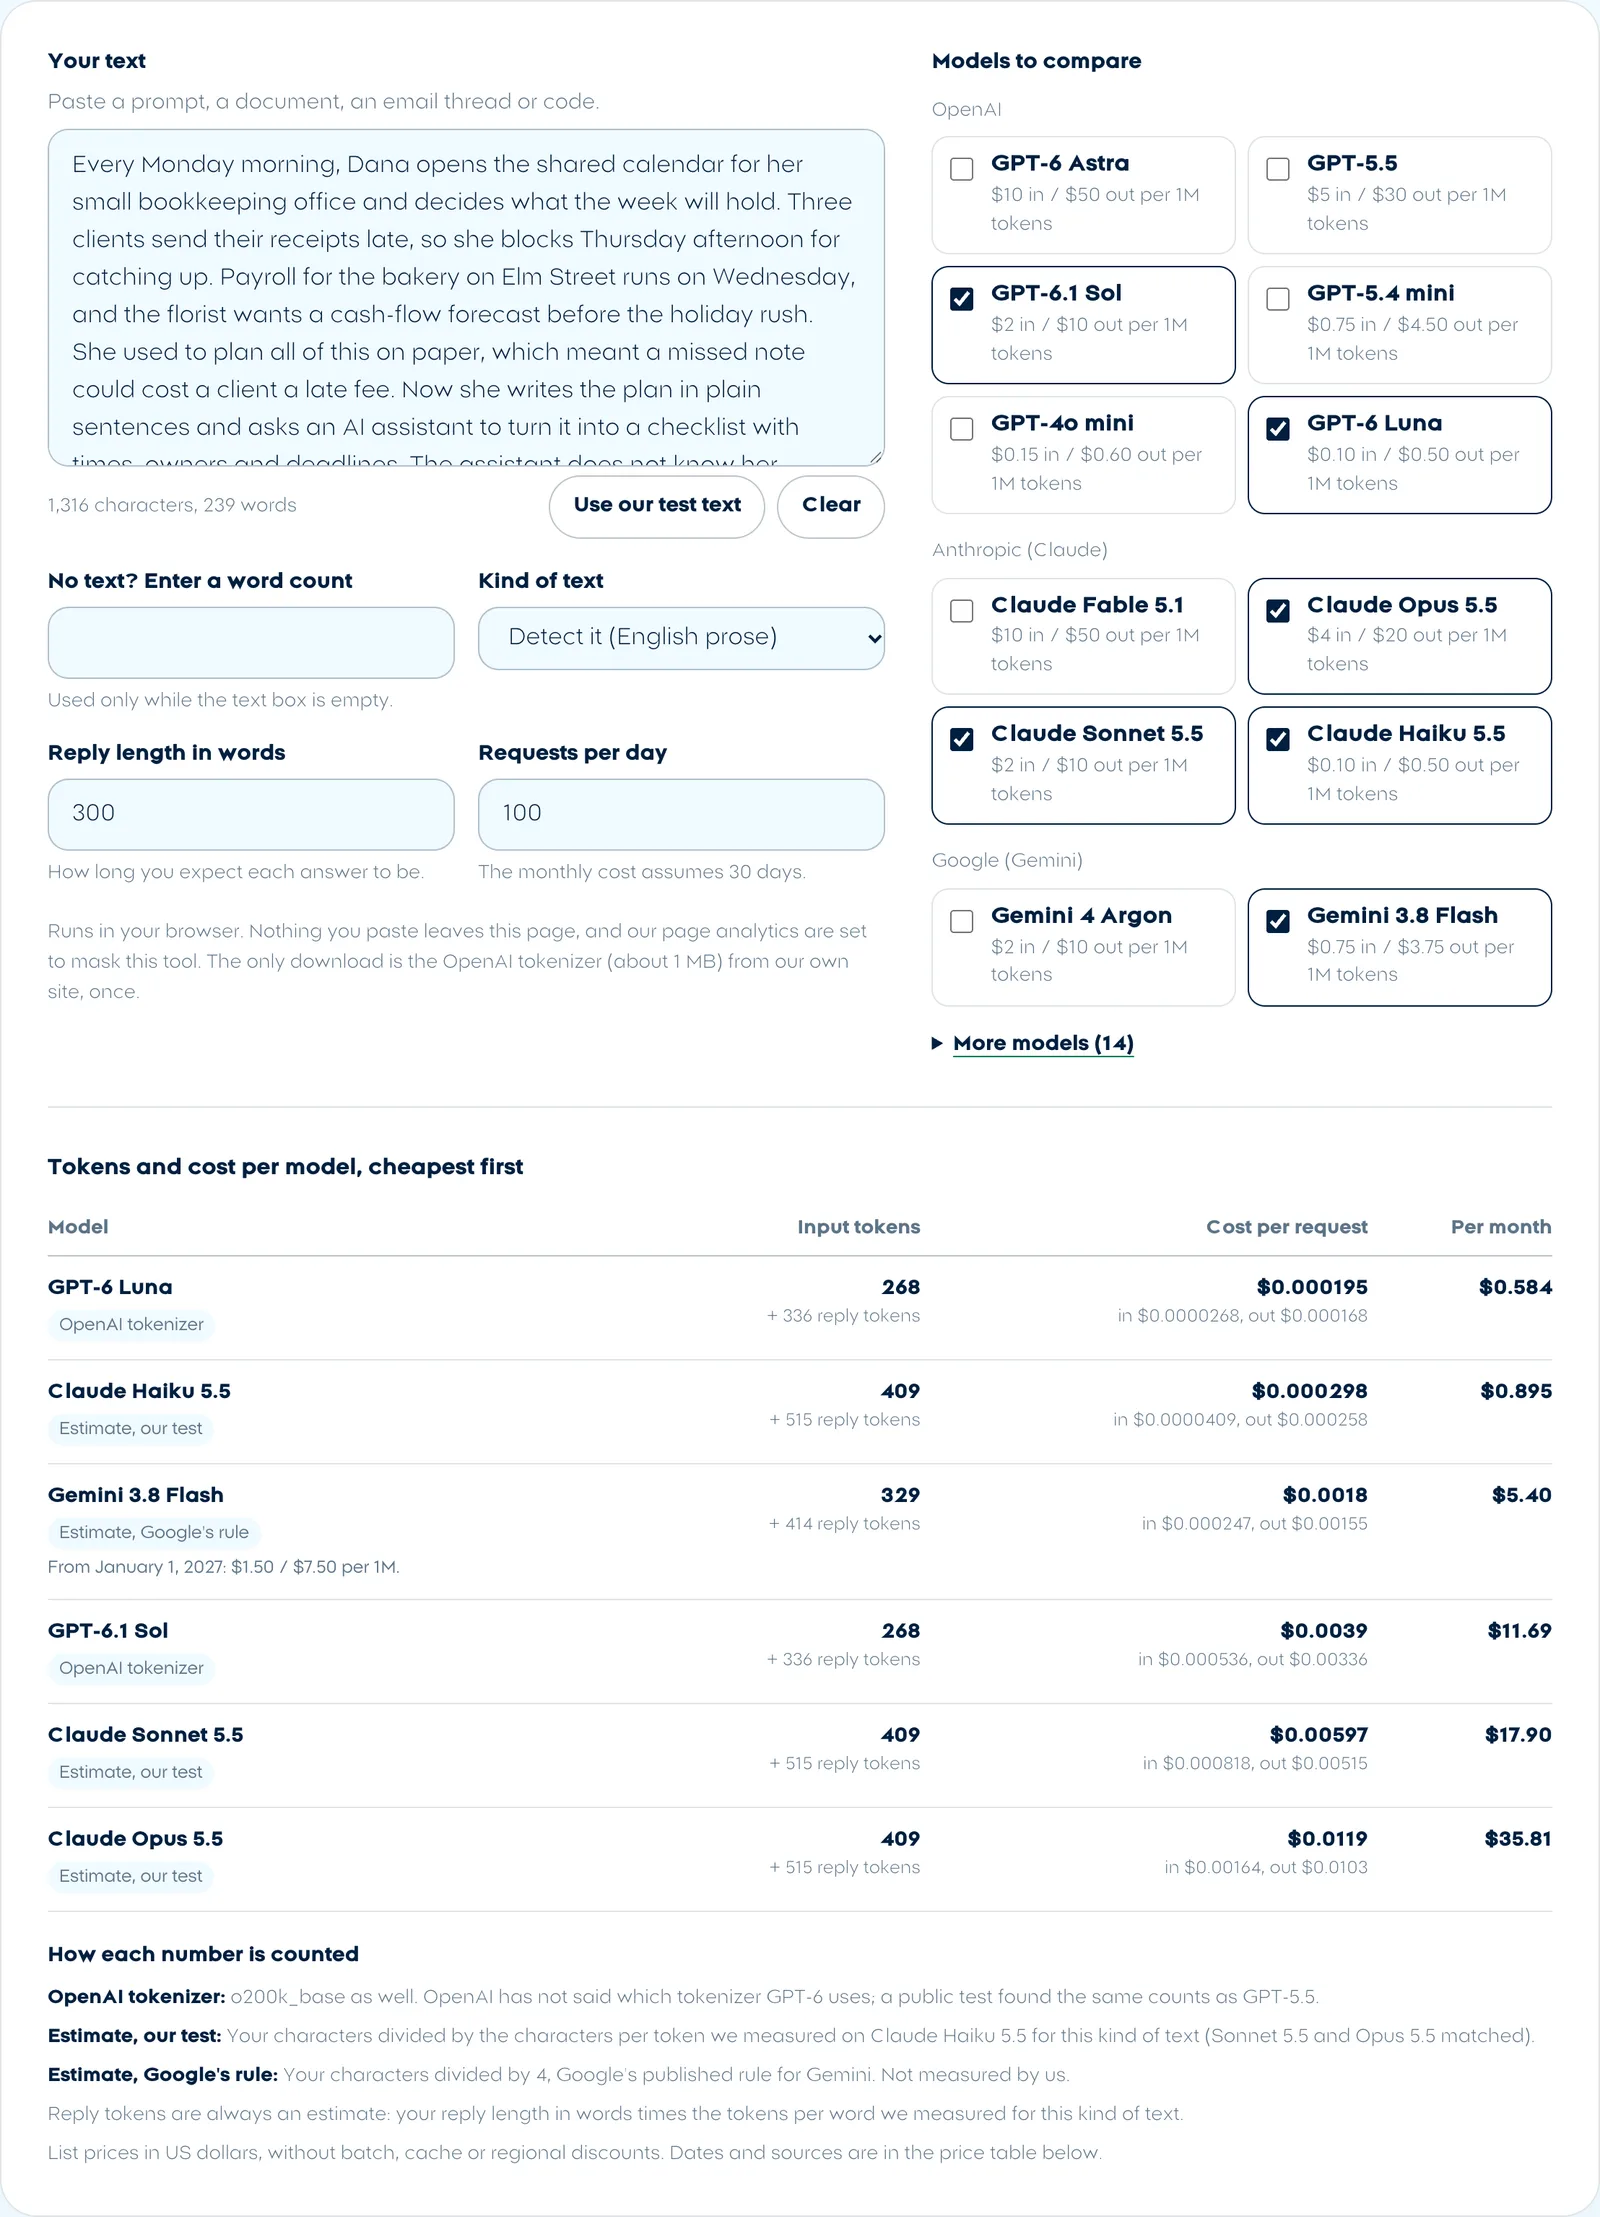
La capture ci-dessous montre ce calculateur en anglais avec notre texte de test anglais (1 316 caractères et 239 mots ; le tableau ci-dessus compte 2 caractères de plus pour le saut de ligne ajouté pendant le test), les six modèles cochés à l'ouverture, une réponse de 300 mots et 100 requêtes par jour. Le tokenizer d'OpenAI a compté 268 tokens, notre estimation Claude 409 et la règle de Google 329 pour Gemini. GPT-6 Luna revient le moins cher, à $0.000195 par requête ($0.584 par mois) ; Claude Opus 5.5 coûte le plus, à $0.0119 par requête ($35.81 par mois), environ 61 fois plus.
Combien coûte un token sur chaque modèle ?
Voici les prix catalogue en dollars américains par million de tokens, en entrée et en sortie, pour les 26 modèles de langage du calculateur, chacun relevé sur la page de tarifs de l'éditeur (une exception : Meta ne publie pas de prix d'API pour Muse Spark Open, sa ligne indique donc le prix d'endpoint listé par Artificial Analysis). La plupart ont été relevés pour notre classement des modèles d'IA le 18 octobre 2026 ; le 28 octobre 2026, nous avons relu les pages d'OpenAI, d'Anthropic et de Google, sans changement. La sortie coûte de 2 à 6 fois le prix de l'entrée sur tous les modèles ici, donc une longue réponse coûte plus cher qu'un long prompt.
| Modèle | Entrée par million | Sortie par million | Remarques | Vérifié le | Source |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Entrée en cache : $1 par 1M de tokens. Entrée maximale de 922,000 tokens sur une fenêtre de 1,050,000 tokens. Au-delà de 272 000 tokens d'entrée : $20 / $75 par million. | 18 octobre 2026 | developers.openai.com |
| GPT-5.5 | $5 | $30 | Au-delà de 272 000 tokens d'entrée : $10 / $45 par million. | 28 octobre 2026 | developers.openai.com |
| GPT-6.1 Sol | $2 | $10 | Entrée en cache : $0.10 par 1M de tokens. Au-delà de 272 000 tokens d'entrée : $4 / $15 par million. | 18 octobre 2026 | developers.openai.com |
| GPT-5.4 mini | $0.75 | $4.50 | 28 octobre 2026 | developers.openai.com | |
| GPT-4o mini | $0.15 | $0.60 | 28 octobre 2026 | developers.openai.com | |
| GPT-6 Luna | $0.10 | $0.50 | Entrée en cache : $0.01 par 1M de tokens. Au-delà de 272 000 tokens d'entrée : $0.20 / $0.75 par million. | 18 octobre 2026 | developers.openai.com |
| Claude Fable 5.1 | $10 | $50 | Les lectures du cache de prompt coûtent 2.5% du prix d'entrée de base ; Batch API à -50%. | 18 octobre 2026 | platform.claude.com |
| Claude Opus 5.5 | $4 | $20 | Lectures du cache : $0.20 par 1M de tokens. Le mode rapide (jusqu'à 2.5x plus vite) coûte $8 en entrée / $40 en sortie par 1M de tokens. | 18 octobre 2026 | platform.claude.com |
| Claude Sonnet 5.5 | $2 | $10 | Les lectures du cache de prompt coûtent 5% du prix d'entrée de base ; Batch API à -50%. | 18 octobre 2026 | platform.claude.com |
| Claude Haiku 5.5 | $0.10 | $0.50 | Anthropic indique ce prix comme un prix de départ ("à partir de"). Au-delà de 100 000 tokens d'entrée : $0.50 / $2.50 par million. | 18 octobre 2026 | platform.claude.com |
| Gemini 4 Argon | $2 | $10 | Prix de lancement jusqu'au 30 novembre 2026 ; $4 en entrée / $20 en sortie par 1M de tokens à partir du 1er décembre 2026. La fenêtre de contexte est partagée entre entrée et sortie (jusqu'à 1M de tokens en sortie avec le décodage long). | 18 octobre 2026 | ai.google.dev |
| Gemini 3.8 Flash | $0.75 | $3.75 | Prix valable jusqu'au 31 décembre 2026 ; $1.50 en entrée / $7.50 en sortie par 1M de tokens à partir du 1er janvier 2027. | 18 octobre 2026 | ai.google.dev |
| Qwen3.8 Max | $2 | $6 | Prix Alibaba Cloud Model Studio, Singapour (international), pour des entrées jusqu'à 1M de tokens. | 18 octobre 2026 | alibabacloud.com |
| Qwen3.8 27B | $0.50 | $3 | Prix sur Alibaba Cloud Model Studio (Singapour) ; les poids sont gratuits à télécharger et à héberger soi-même. | 18 octobre 2026 | alibabacloud.com |
| DeepSeek V4 Pro | $1.32 | $3.96 | Prix en heures pleines ; en heures creuses, les tarifs sont divisés par deux ($0.66 / $1.98). Entrée en cache (cache hit) $0.044 en heures pleines. | 18 octobre 2026 | api-docs.deepseek.com |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | Prix en heures pleines ; en heures creuses, les tarifs sont divisés par deux ($0.15 / $0.60). Entrée en cache (cache hit) $0.006 en heures pleines. | 18 octobre 2026 | api-docs.deepseek.com |
| Muse Wonder | $4 | $20 | ID du modèle API muse-wonder-1.0 ; entrée en cache $0.20 par 1M de tokens. Le plus puissant Muse Wonder Full n'est inclus que dans les abonnements Muse Code. | 18 octobre 2026 | dev.meta.ai |
| Muse Spark 1.3 | $1.25 | $4.25 | ID du modèle muse-spark-1.3 ; entrée en cache $0.15. Une variante muse-spark-1.3-contributor ($0.10 / $0.20) peut être utilisée pour améliorer les produits Meta. | 18 octobre 2026 | dev.meta.ai |
| Muse Spark Open | $1.25 | $4.25 | Poids ouverts (dépôt Hugging Face meta-models/Muse-Spark-Open-816B-A42B). Meta n'indique pas de prix par token ; c'est le prix d'endpoint affiché par Artificial Analysis. | 18 octobre 2026 | artificialanalysis.ai |
| MiniMax-M3 | $0.30 | $1.20 | Prix standard réduit pour les prompts jusqu'à 512K tokens (prix catalogue $0.60 / $2.40) ; $0.60 / $2.40 au-delà de 512K tokens. | 18 octobre 2026 | platform.minimax.io |
| Mistral Large 4 | $1.36 | $4.18 | Prix normal ; Mistral affichait une offre de lancement à moitié prix ($0.68 / $2.09, entrée en cache $0.07) au moment de ce relevé. | 18 octobre 2026 | docs.mistral.ai |
| Kimi K3 | $3 | $15 | Entrée en cache (cache hit) $0.30 par 1M de tokens ; écritures en cache $3 (TTL de 5 minutes) ou $6 (TTL d'1 heure). | 18 octobre 2026 | platform.kimi.ai |
| Grok 4.7 | $2 | $6 | Pour les prompts de moins de 200K tokens. Les prompts de 200K tokens ou plus sont facturés $4 en entrée / $12 en sortie par 1M de tokens. Entrée en cache : $0.50. | 18 octobre 2026 | docs.x.ai |
| MiMo-V2.6-Pro | $0.435 | $0.87 | Prix de l'API temps réel internationale ; entrée en cache (cache hit) $0.0036 par 1M de tokens. Un niveau UltraSpeed plus rapide coûte 10x plus. | 18 octobre 2026 | mimo.mi.com |
| GLM-5.3 | $1.40 | $4.40 | Entrée en cache : $0.26 par 1M de tokens. Z.ai vend aussi un abonnement GLM Coding Plan. | 18 octobre 2026 | docs.z.ai |
| GLM-5.3-Flash | $0.15 | $0.50 | Entrée en cache : $0.03 par 1M de tokens. | 18 octobre 2026 | docs.z.ai |
Le calculateur n'utilise que les prix catalogue. Le traitement par lots coûte moitié moins chez Anthropic et chez OpenAI, dont la page de tarifs affiche des prix par lots à la moitié des prix standard pour les modèles GPT-6, et l'entrée en cache coûte une fraction du prix catalogue : une vraie facture peut donc être plus basse.
Comment réduire le coût des tokens ?
Cinq habitudes font l'essentiel du travail, et chacune se voit dans le calculateur : changez la longueur de la réponse, le modèle ou le texte et regardez le montant mensuel bouger.
- Mettez en cache ce qui se répète. Si vos requêtes commencent par les mêmes instructions ou le même document, le prompt caching facture la répétition à une fraction du prix d'entrée : 5 % sur Claude Opus 5.5 et Sonnet 5.5 (Anthropic), et $0.10 au lieu de $2 par million de tokens sur GPT-6.1 Sol (OpenAI). Claude Code le fait déjà : même avec ses outils désactivés, il a envoyé 3 200 à 4 000 tokens de ses propres instructions avec chaque requête d'une ligne dans notre test, et après la première requête la plupart ont été comptés comme lectures de cache.
- Passez par les lots quand rien ne presse. Rapports, classement et résumés qui peuvent arriver dans quelques heures coûtent moitié moins avec la Batch API d'Anthropic et les tarifs par lots d'OpenAI.
- Testez d'abord le petit modèle. Claude Haiku 5.5 coûte $0.10 / $0.50 par million de tokens contre $4 / $20 pour Claude Opus 5.5, soit 40 fois moins. Faites passer quelques-unes de vos vraies requêtes sur les deux avant d'adopter le grand.
- Restez sous le seuil des longs prompts. Claude Haiku 5.5 facture 5 fois plus les prompts de plus de 100 000 tokens, et les modèles GPT-6 doublent le prix de l'entrée et multiplient celui de la sortie par 1,5 au-delà de 272 000 tokens d'entrée. Collez la partie du document dont la tâche a besoin, pas le fichier entier, et allégez l'historique de la conversation.
- Demandez des réponses plus courtes. La sortie coûte de 2 à 6 fois le prix de l'entrée, alors précisez la longueur voulue (« trois puces ») et fixez un maximum de sortie dans l'API. Les modèles qui réfléchissent avant de répondre facturent aussi cette réflexion comme sortie : la page de tarifs de Google intitule son prix de sortie « including thinking tokens » (tokens de réflexion inclus).
Si vous utilisez Claude Code avec un abonnement plutôt qu'avec l'API, les tokens prennent la forme de limites d'utilisation plutôt que d'une facture ; notre guide des limites d'utilisation de Claude Code explique les plafonds de 5 heures et hebdomadaires et comment les faire durer.
Questions fréquentes
Combien de tokens font 1 000 mots ?
Dans notre test, 1 000 mots de français ont donné environ 1 300 tokens avec le tokenizer d'OpenAI et environ 2 300 avec Claude ; en anglais, environ 1 100 et 1 700. L'espagnol et le portugais sont un peu en dessous du français (environ 1 200 tokens OpenAI et 2 100 à 2 200 tokens Claude). La règle de Google pour Gemini donne environ 1 450 tokens pour 1 000 mots de français et 1 400 en anglais.
Pourquoi Claude compte-t-il plus de tokens que GPT pour le même texte ?
Chaque entreprise entraîne son propre tokenizer, et celui de Claude découpe le texte en morceaux plus petits : dans notre test, il lui a fallu 1,28 à 1,78 fois les tokens d'OpenAI pour le même texte (1,77 en français). Comparez donc le coût par requête dans le calculateur, pas le prix par token : un prix par token plus bas peut quand même donner une facture plus élevée.
Le décompte de tokens correspond-il à ce que je paie ?
Presque, mais l'API compte aussi ce qui entoure votre texte : le prompt système, les définitions d'outils et le formatage des messages. Les modèles qui raisonnent facturent en plus ce raisonnement comme sortie. Dans notre test avec Claude Code, un prompt d'un seul mot a fait 3 998 tokens d'entrée ; les chiffres d'usage de chaque réponse de l'API sont la vraie facture.
Ce calculateur de tokens envoie-t-il mon texte quelque part ?
Non. Le comptage et le calcul du coût se font dans votre navigateur, et l'outil est masqué pour notre mesure d'audience (Microsoft Clarity) : votre texte n'est pas enregistré. Le seul téléchargement est le fichier du tokenizer d'OpenAI, environ 1 Mo, depuis notre propre site, la première fois que vous tapez.
Comment obtenir un décompte exact pour Claude ou Gemini ?
Utilisez le compteur de l'éditeur. L'endpoint de comptage de tokens d'Anthropic est gratuit avec une clé d'API, et l'API Gemini propose un appel countTokens ; les deux comptent avec le tokenizer du modèle que vous indiquez. Sans clé, les ratios que nous avons mesurés ici sont l'estimation la plus proche.