Calculadora de tokens de IA: tokens y costo de API por modelo
Un token es el pedacito de texto que un modelo de IA lee y cobra, a menudo una parte de una palabra. En nuestra prueba del 28 de octubre de 2026, Claude usó un token por cada 3,2 caracteres de inglés y el tokenizador de OpenAI uno por cada 4,9; en español, uno por cada 2,6 y 4,5. Pega tu texto abajo para ver el conteo y el costo de la API en cada modelo.
Actualizado
Calculadora de tokens
Funciona en tu navegador. Nada de lo que pegas sale de esta página, y nuestra analítica está configurada para ocultar esta herramienta. Lo único que se descarga es el tokenizador de OpenAI (alrededor de 1 MB), desde nuestro sitio, una sola vez.
Pega un texto o escribe un número de palabras para ver los tokens y el costo.
¿Cómo cuenta los tokens esta calculadora de tokens?
Cada empresa de IA divide el texto a su manera, así que el mismo párrafo da un número distinto de tokens en cada modelo. Esta calculadora usa el mejor método que permite cada empresa y marca cada número con el suyo.
- Modelos de OpenAI: conteo exacto. Como calculadora de tokens de OpenAI, ejecuta en tu navegador el tokenizador o200k_base de OpenAI, con la biblioteca de código abierto gpt-tokenizer (versión 4.0.0). La biblioteca de tokenización de la propia OpenAI, tiktoken, asigna o200k_base a GPT-4o, GPT-4.1 y todos los modelos GPT-5.
- Modelos GPT-6: el mismo tokenizador, sin confirmar. tiktoken no tiene una entrada para GPT-6 al 28 de octubre de 2026, y OpenAI no ha dicho qué tokenizador usa GPT-6. Una comparación pública de 31 textos, hecha el 26 de septiembre de 2026, encontró que GPT-6 Astra, Sol y Luna reportan exactamente los mismos tokens de entrada que GPT-5.5, así que los contamos con o200k_base y lo indicamos.
- Modelos Claude: nuestra estimación medida. Anthropic no ofrece un tokenizador que funcione sin conexión, así que la calculadora de tokens de Claude divide tus caracteres entre la proporción que medimos para ese tipo de texto (tabla abajo). La página de precios de Anthropic dice que los modelos Claude 4.7 y posteriores comparten un tokenizador más nuevo, y en nuestra prueba Haiku 5.5, Sonnet 5.5 y Opus 5.5 coincidieron con 4 tokens de diferencia como máximo.
- Modelos Gemini: la regla de Google. Como calculadora de tokens de Gemini, usa la regla general de la propia Google: unos 4 caracteres por token. No medimos Gemini, porque eso requiere una clave de API de Google.
- Otros modelos (Grok, DeepSeek, Qwen, Mistral, Kimi y el resto): no hay un tokenizador para ellos en el navegador, así que la calculadora muestra el conteo de OpenAI como sustituto y lo indica.
Cómo medimos Claude
El 28 de octubre de 2026 enviamos seis textos con Claude Code 2.1.303 y Claude Haiku 5.5, desde una carpeta vacía y con todas las herramientas desactivadas, y leímos los tokens de entrada en su salida JSON. La misma solicitud sin el texto (una instrucción fija de una línea) dio unos 4008 tokens, medidos cuatro veces; al restarla quedan los tokens del texto. El texto en inglés y el código se enviaron dos veces y coincidieron con 5 tokens de diferencia como máximo, y Claude Sonnet 5.5 y Opus 5.5 recibieron esos dos textos como control.
| Tipo de texto | Caracteres | Tokens de Claude | Caracteres por token de Claude | Tokens de OpenAI | Caracteres por token de OpenAI | Claude frente a OpenAI |
|---|---|---|---|---|---|---|
| Prosa en inglés | 1318 | 410 | 3,21 | 268 | 4,92 | 1,53x |
| Prosa en español | 1465 | 558,5 | 2,62 | 324 | 4,52 | 1,72x |
| Prosa en portugués | 1463 | 577,5 | 2,53 | 324 | 4,52 | 1,78x |
| Prosa en francés | 1536 | 603,5 | 2,55 | 341 | 4,5 | 1,77x |
| Código | 1662 | 750 | 2,22 | 521 | 3,19 | 1,44x |
| Tabla o datos | 766 | 499,5 | 1,53 | 390 | 1,96 | 1,28x |
Claude necesitó entre 1,28 y 1,78 veces los tokens de OpenAI para el mismo texto: la menor diferencia en la tabla y la mayor en portugués. Coincide con la comparación pública de arriba, donde Claude Opus 5.5 contó un 53,9 % más de tokens que GPT-5.5 en sus 31 textos. Una muestra por tipo de texto da una regla general, no una garantía: para un conteo exacto de Claude, el endpoint de conteo de tokens de Anthropic es gratis con una clave de API.
Nada de lo que pegas sale de la página. El conteo y el cálculo del costo se hacen en tu navegador, la herramienta está oculta para nuestra analítica de la página y el único archivo que descarga es el tokenizador de OpenAI (alrededor de 1 MB), desde nuestro propio sitio.
¿Qué muestra la calculadora?
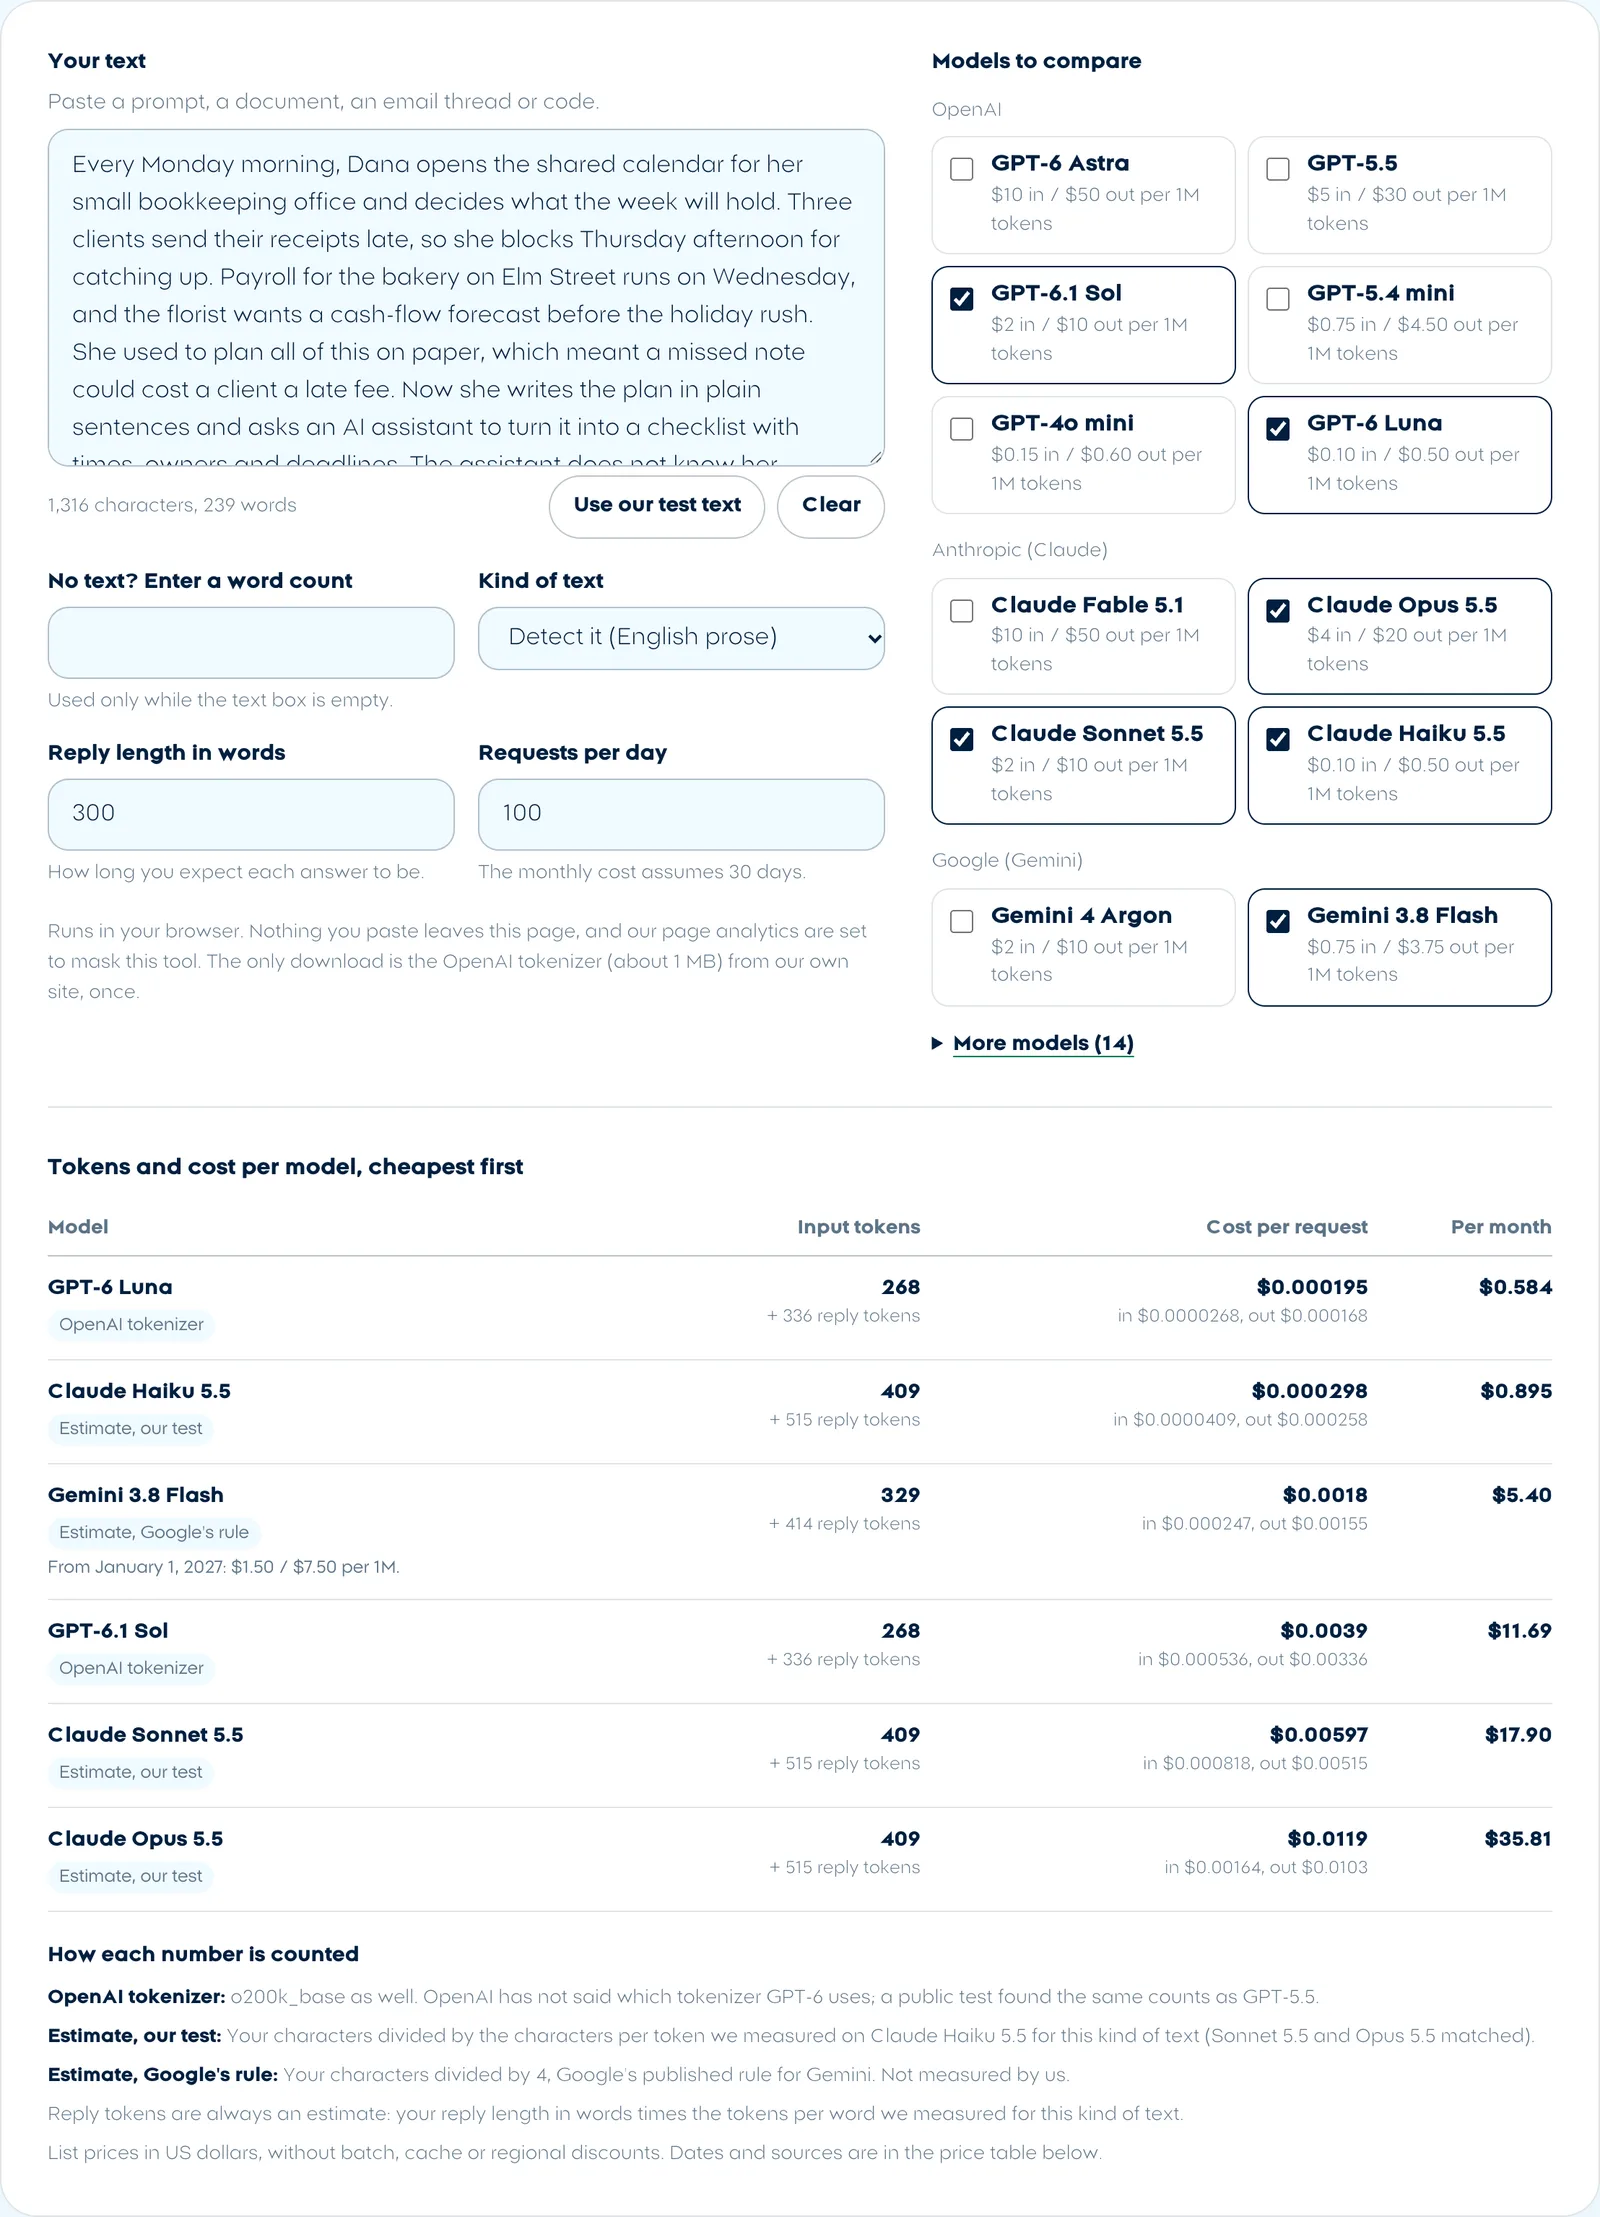
La captura de abajo es esta calculadora en inglés, con nuestro texto de prueba en inglés (1316 caracteres y 239 palabras; la tabla de arriba cuenta 2 caracteres más por el salto de línea que añadió la prueba), los seis modelos con los que abre, una respuesta de 300 palabras y 100 solicitudes al día. El tokenizador de OpenAI contó 268 tokens, nuestra estimación de Claude dio 409 y la regla de Google, 329 para Gemini. GPT-6 Luna fue el más barato, con $0.000195 por solicitud ($0.584 al mes); Claude Opus 5.5 fue el más caro, con $0.0119 por solicitud ($35.81 al mes), unas 61 veces más.
¿Cuánto cuesta un token en cada modelo?
Estos son precios de lista en dólares estadounidenses por cada millón de tokens, de entrada y de salida, para los 26 modelos de lenguaje de la calculadora, cada uno tomado de la página de precios de su proveedor (una excepción: Meta no publica un precio de API para Muse Spark Open, así que su fila muestra el precio del endpoint que lista Artificial Analysis). La mayoría se leyeron para nuestro ranking de modelos de IA el 18 de octubre de 2026; el 28 de octubre de 2026 volvimos a leer las páginas de OpenAI, Anthropic y Google y seguían igual. La salida cuesta entre 2 y 6 veces lo que cuesta la entrada en todos los modelos de aquí, así que una respuesta larga cuesta más que un prompt largo.
| Modelo | Entrada por 1M | Salida por 1M | Notas | Revisado | Fuente |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Entrada en caché $1 por 1M tokens. La entrada máxima es de 922,000 tokens de la ventana de 1,050,000 tokens. Más de 272.000 tokens de entrada: $20 / $75 por 1M. | 18 de octubre de 2026 | developers.openai.com |
| GPT-5.5 | $5 | $30 | Más de 272.000 tokens de entrada: $10 / $45 por 1M. | 28 de octubre de 2026 | developers.openai.com |
| GPT-6.1 Sol | $2 | $10 | Entrada en caché $0.10 por 1M tokens. Más de 272.000 tokens de entrada: $4 / $15 por 1M. | 18 de octubre de 2026 | developers.openai.com |
| GPT-5.4 mini | $0.75 | $4.50 | 28 de octubre de 2026 | developers.openai.com | |
| GPT-4o mini | $0.15 | $0.60 | 28 de octubre de 2026 | developers.openai.com | |
| GPT-6 Luna | $0.10 | $0.50 | Entrada en caché $0.01 por 1M tokens. Más de 272.000 tokens de entrada: $0.20 / $0.75 por 1M. | 18 de octubre de 2026 | developers.openai.com |
| Claude Fable 5.1 | $10 | $50 | Las lecturas de caché de prompts cuestan el 2.5% del precio base de entrada; la Batch API tiene 50% de descuento. | 18 de octubre de 2026 | platform.claude.com |
| Claude Opus 5.5 | $4 | $20 | Lecturas de caché $0.20 por 1M tokens. El modo rápido (hasta 2.5x de velocidad) cuesta $8 de entrada / $40 de salida por 1M tokens. | 18 de octubre de 2026 | platform.claude.com |
| Claude Sonnet 5.5 | $2 | $10 | Las lecturas de caché de prompts cuestan el 5% del precio base de entrada; la Batch API tiene 50% de descuento. | 18 de octubre de 2026 | platform.claude.com |
| Claude Haiku 5.5 | $0.10 | $0.50 | Anthropic lo publica como precio inicial ("desde"). Más de 100.000 tokens de entrada: $0.50 / $2.50 por 1M. | 18 de octubre de 2026 | platform.claude.com |
| Gemini 4 Argon | $2 | $10 | Precio introductorio hasta el 30 de noviembre de 2026; $4 de entrada / $20 de salida por 1M tokens desde el 1 de diciembre de 2026. La ventana de contexto se comparte entre entrada y salida (hasta 1M tokens de salida con decodificación larga). | 18 de octubre de 2026 | ai.google.dev |
| Gemini 3.8 Flash | $0.75 | $3.75 | El precio aplica hasta el 31 de diciembre de 2026; $1.50 de entrada / $7.50 de salida por 1M tokens desde el 1 de enero de 2027. | 18 de octubre de 2026 | ai.google.dev |
| Qwen3.8 Max | $2 | $6 | Alibaba Cloud Model Studio, precio de Singapur (internacional) para entradas de hasta 1M tokens. | 18 de octubre de 2026 | alibabacloud.com |
| Qwen3.8 27B | $0.50 | $3 | Precio en Alibaba Cloud Model Studio (Singapur); los pesos se pueden descargar gratis y alojar uno mismo. | 18 de octubre de 2026 | alibabacloud.com |
| DeepSeek V4 Pro | $1.32 | $3.96 | Precio en hora pico; fuera de hora pico es la mitad ($0.66 / $1.98). Entrada con acierto de caché $0.044 en hora pico. | 18 de octubre de 2026 | api-docs.deepseek.com |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | Precio en hora pico; fuera de hora pico es la mitad ($0.15 / $0.60). Entrada con acierto de caché $0.006 en hora pico. | 18 de octubre de 2026 | api-docs.deepseek.com |
| Muse Wonder | $4 | $20 | ID del modelo en la API muse-wonder-1.0; entrada en caché $0.20 por 1M tokens. El más potente Muse Wonder Full solo está incluido en las suscripciones de Muse Code. | 18 de octubre de 2026 | dev.meta.ai |
| Muse Spark 1.3 | $1.25 | $4.25 | ID del modelo muse-spark-1.3; entrada en caché $0.15. Una variante muse-spark-1.3-contributor ($0.10 / $0.20) puede usarse para mejorar los productos de Meta. | 18 de octubre de 2026 | dev.meta.ai |
| Muse Spark Open | $1.25 | $4.25 | Pesos abiertos (repo de Hugging Face meta-models/Muse-Spark-Open-816B-A42B). Meta no publica precio por token; este es el precio del endpoint que muestra Artificial Analysis. | 18 de octubre de 2026 | artificialanalysis.ai |
| MiniMax-M3 | $0.30 | $1.20 | Precio estándar con descuento para prompts de hasta 512K tokens (precio de lista $0.60 / $2.40); $0.60 / $2.40 por encima de 512K tokens. | 18 de octubre de 2026 | platform.minimax.io |
| Mistral Large 4 | $1.36 | $4.18 | Precio regular; Mistral mostraba una oferta de lanzamiento a mitad de precio ($0.68 / $2.09, entrada en caché $0.07) al momento de este registro. | 18 de octubre de 2026 | docs.mistral.ai |
| Kimi K3 | $3 | $15 | Entrada con acierto de caché $0.30 por 1M tokens; escrituras de caché $3 (TTL de 5 minutos) o $6 (TTL de 1 hora). | 18 de octubre de 2026 | platform.kimi.ai |
| Grok 4.7 | $2 | $6 | Para prompts de menos de 200K tokens. Los prompts de 200K tokens o más se cobran a $4 de entrada / $12 de salida por 1M tokens. Entrada en caché $0.50. | 18 de octubre de 2026 | docs.x.ai |
| MiMo-V2.6-Pro | $0.435 | $0.87 | Precio de la API en tiempo real para el exterior; entrada con acierto de caché $0.0036 por 1M tokens. Un nivel UltraSpeed más rápido cuesta 10x más. | 18 de octubre de 2026 | mimo.mi.com |
| GLM-5.3 | $1.40 | $4.40 | Entrada en caché $0.26 por 1M tokens. Z.ai también vende una suscripción GLM Coding Plan. | 18 de octubre de 2026 | docs.z.ai |
| GLM-5.3-Flash | $0.15 | $0.50 | Entrada en caché $0.03 por 1M tokens. | 18 de octubre de 2026 | docs.z.ai |
La calculadora usa solo precios de lista. El procesamiento por lotes cuesta la mitad en Anthropic y en OpenAI, cuya página de precios lista tarifas por lotes a la mitad de las estándar para los modelos GPT-6, y la entrada en caché cuesta una fracción del precio de lista, así que una factura real puede ser menor.
¿Cómo reducir el costo de los tokens?
Cinco hábitos hacen la mayor parte del trabajo, y cada uno se ve en la calculadora: cambia el largo de la respuesta, el modelo o el texto y mira cómo se mueve la cifra mensual.
- Usa caché para lo que se repite. Si tus solicitudes empiezan con las mismas instrucciones o el mismo documento, el prompt caching cobra la repetición a una fracción del precio de entrada: el 5 % en Claude Opus 5.5 y Sonnet 5.5 (Anthropic), y $0.10 en vez de $2 por millón de tokens en GPT-6.1 Sol (OpenAI). Claude Code ya lo hace: incluso con sus herramientas desactivadas, envió entre 3200 y 4000 tokens de instrucciones propias con cada solicitud de una línea en nuestra prueba, y después de la primera solicitud la mayoría se contaron como lecturas de caché.
- Manda por lotes lo que puede esperar. Informes, etiquetado y resúmenes que pueden llegar en unas horas cuestan la mitad con la Batch API de Anthropic y las tarifas por lotes de OpenAI.
- Prueba primero el modelo pequeño. Claude Haiku 5.5 cuesta $0.10 / $0.50 por millón de tokens frente a $4 / $20 de Claude Opus 5.5, 40 veces menos. Prueba algunas de tus solicitudes reales en ambos antes de quedarte con el grande.
- Quédate por debajo del límite de prompts largos. Claude Haiku 5.5 cobra 5 veces más por los prompts de más de 100.000 tokens, y los modelos GPT-6 cobran el doble por la entrada y 1,5 veces por la salida por encima de 272.000 tokens de entrada. Pega la parte del documento que la tarea necesita, no el archivo entero, y recorta el historial viejo del chat.
- Pide respuestas más cortas. La salida cuesta entre 2 y 6 veces lo que la entrada, así que di el largo que quieres («tres viñetas») y fija un máximo de salida en la API. Los modelos que piensan antes de responder también cobran ese razonamiento como salida: la página de precios de Google titula su precio de salida «including thinking tokens» (incluidos los tokens de razonamiento).
Si usas Claude Code con una suscripción y no con la API, los tokens aparecen como límites de uso en vez de una factura; nuestra guía de límites de uso de Claude Code explica los topes de 5 horas y semanales y cómo hacerlos rendir.
Preguntas frecuentes
¿Cuántos tokens son 1000 palabras?
En nuestra prueba, 1000 palabras en español dieron unos 1200 tokens con el tokenizador de OpenAI y unos 2100 con Claude; en inglés, unos 1100 y 1700. El portugués y el francés quedaron cerca del español (entre 1200 y 1300 tokens de OpenAI y entre 2200 y 2300 de Claude). La regla de Google para Gemini da unos 1400 tokens en español y en inglés.
¿Por qué Claude cuenta más tokens que GPT para el mismo texto?
Cada empresa entrena su propio tokenizador, y el de Claude corta el texto en pedazos más pequeños: en nuestra prueba necesitó entre 1,28 y 1,78 veces los tokens de OpenAI para el mismo texto (1,72 en español). Por eso conviene comparar el costo por solicitud en la calculadora, no el precio por token: un precio por token más bajo puede terminar en una factura más alta.
¿El conteo de tokens es igual a lo que pago?
Se acerca, pero la API también cuenta lo que envuelve tu texto: el prompt del sistema, las definiciones de herramientas y el formato de los mensajes. Los modelos que razonan además cobran ese razonamiento como salida. En nuestra prueba con Claude Code, un prompt de una palabra sumó 3998 tokens de entrada; las cifras de uso de cada respuesta de la API son la factura real.
¿Esta calculadora de tokens envía mi texto a algún lado?
No. El conteo y el cálculo del costo se hacen en tu navegador, y la herramienta está oculta para nuestra analítica de la página (Microsoft Clarity), así que tu texto no se graba. Lo único que se descarga es el archivo del tokenizador de OpenAI, de alrededor de 1 MB, desde nuestro propio sitio la primera vez que escribes.
¿Cómo obtengo un conteo exacto de Claude o Gemini?
Usa el contador del propio proveedor. El endpoint de conteo de tokens de Anthropic es gratis con una clave de API, y la API de Gemini tiene una llamada countTokens; los dos cuentan con el tokenizador del modelo que indiques. Sin clave, las proporciones que medimos aquí son la estimación más cercana.