Calculadora de tokens de IA: tokens e custo de API por modelo
Um token é o pedacinho de texto que um modelo de IA lê e cobra, muitas vezes parte de uma palavra. No nosso teste de 28 de outubro de 2026, o Claude usou um token a cada 3,2 caracteres de inglês e o tokenizador da OpenAI um a cada 4,9; em português, um a cada 2,5 e 4,5. Cole seu texto abaixo para ver a contagem e o custo da API em cada modelo.
Atualizado
Calculadora de tokens
Funciona no seu navegador. Nada do que você cola sai desta página, e a análise de uso do site está configurada para ocultar esta ferramenta. O único download é o tokenizador da OpenAI (cerca de 1 MB), do nosso site, uma única vez.
Cole um texto ou digite um número de palavras para ver os tokens e o custo.
Como esta calculadora de tokens conta os tokens?
Cada empresa de IA divide o texto do seu jeito, então o mesmo parágrafo dá um número diferente de tokens em cada modelo. Esta calculadora usa o melhor método que cada empresa permite e marca cada número com o seu.
- Modelos da OpenAI: contagem exata. Como calculadora de tokens da OpenAI, ela roda no seu navegador o tokenizador o200k_base da OpenAI, pela biblioteca de código aberto gpt-tokenizer (versão 4.0.0). A biblioteca de tokenização da própria OpenAI, o tiktoken, associa o o200k_base ao GPT-4o, ao GPT-4.1 e a todos os modelos GPT-5.
- Modelos GPT-6: o mesmo tokenizador, ainda sem confirmação. O tiktoken não tem uma entrada para o GPT-6 em 28 de outubro de 2026, e a OpenAI não disse qual tokenizador o GPT-6 usa. Uma comparação pública de 31 textos, feita em 26 de setembro de 2026, viu o GPT-6 Astra, Sol e Luna informarem exatamente as mesmas contagens de entrada que o GPT-5.5, então contamos esses modelos com o o200k_base e avisamos.
- Modelos Claude: nossa estimativa medida. A Anthropic não oferece um tokenizador que funcione offline, então a calculadora de tokens do Claude divide seus caracteres pela proporção que medimos para aquele tipo de texto (tabela abaixo). A página de preços da Anthropic diz que os modelos Claude 4.7 e posteriores compartilham um tokenizador mais novo, e no nosso teste o Haiku 5.5, o Sonnet 5.5 e o Opus 5.5 ficaram a no máximo 4 tokens de diferença.
- Modelos Gemini: a regra do Google. Como calculadora de tokens do Gemini, ela usa a regra prática do próprio Google: cerca de 4 caracteres por token. Não medimos o Gemini, porque isso exige uma chave de API do Google.
- Outros modelos (Grok, DeepSeek, Qwen, Mistral, Kimi e os demais): não existe um tokenizador deles no navegador, então a calculadora mostra a contagem da OpenAI como substituta e avisa.
Como medimos o Claude
Em 28 de outubro de 2026, enviamos seis textos pelo Claude Code 2.1.303 com o Claude Haiku 5.5, a partir de uma pasta vazia e com todas as ferramentas desligadas, e lemos os tokens de entrada na saída JSON. O mesmo pedido sem o texto (uma instrução fixa de uma linha) deu cerca de 4.008 tokens, medidos quatro vezes; subtraindo esse valor, sobram os tokens do próprio texto. O texto em inglês e o código rodaram duas vezes e ficaram a no máximo 5 tokens de diferença, e o Claude Sonnet 5.5 e o Opus 5.5 receberam esses dois textos como checagem.
| Tipo de texto | Caracteres | Tokens do Claude | Caracteres por token do Claude | Tokens da OpenAI | Caracteres por token da OpenAI | Claude contra OpenAI |
|---|---|---|---|---|---|---|
| Texto em inglês | 1.318 | 410 | 3,21 | 268 | 4,92 | 1,53x |
| Texto em espanhol | 1.465 | 558,5 | 2,62 | 324 | 4,52 | 1,72x |
| Texto em português | 1.463 | 577,5 | 2,53 | 324 | 4,52 | 1,78x |
| Texto em francês | 1.536 | 603,5 | 2,55 | 341 | 4,5 | 1,77x |
| Código | 1.662 | 750 | 2,22 | 521 | 3,19 | 1,44x |
| Tabela ou dados | 766 | 499,5 | 1,53 | 390 | 1,96 | 1,28x |
O Claude precisou de 1,28 a 1,78 vez os tokens da OpenAI para o mesmo texto: a menor diferença na tabela e a maior em português. Isso bate com a comparação pública acima, em que o Claude Opus 5.5 contou 53,9% mais tokens que o GPT-5.5 nos 31 textos. Uma amostra por tipo de texto dá uma regra prática, não uma garantia: para uma contagem exata do Claude, o endpoint de contagem de tokens da Anthropic é gratuito com uma chave de API.
Nada do que você cola sai da página. A contagem e a conta do custo rodam no seu navegador, a ferramenta fica oculta para a análise de uso do site e o único arquivo baixado é o tokenizador da OpenAI (cerca de 1 MB), do nosso próprio site.
O que a calculadora mostra?
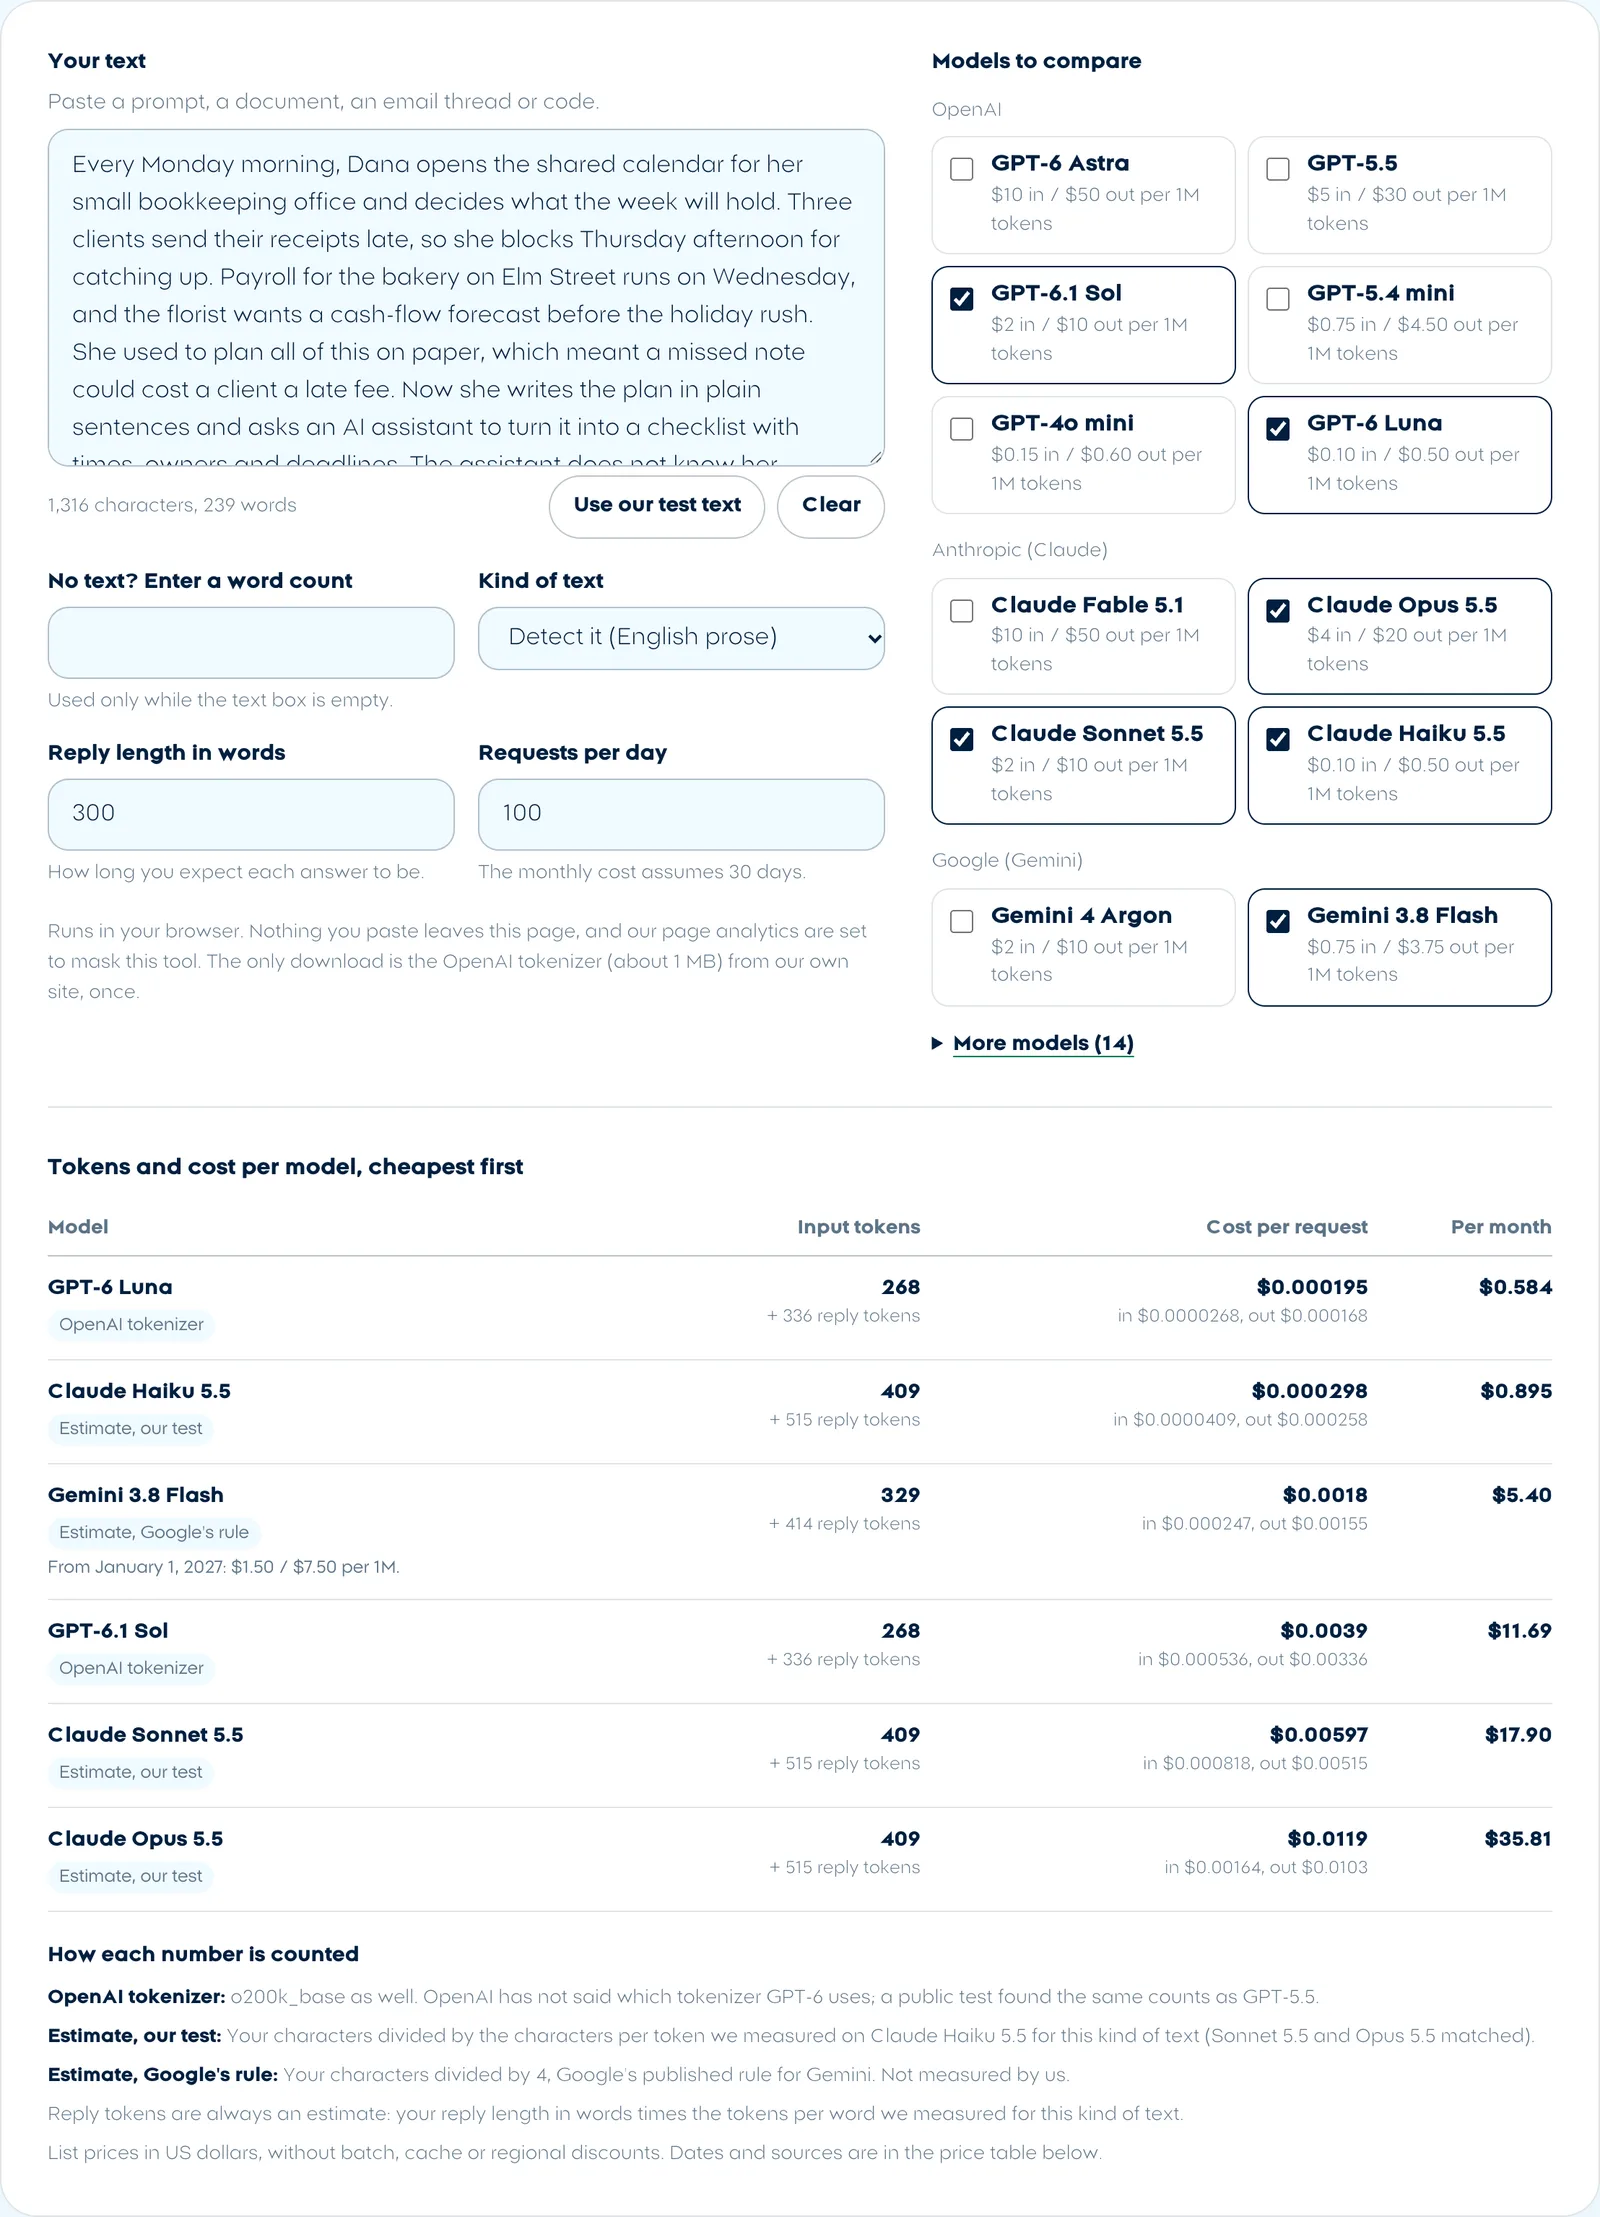
A captura abaixo é esta calculadora em inglês, com nosso texto de teste em inglês (1.316 caracteres e 239 palavras; a tabela acima conta 2 caracteres a mais pela quebra de linha que o teste acrescentou), os seis modelos com que ela abre, uma resposta de 300 palavras e 100 pedidos por dia. O tokenizador da OpenAI contou 268 tokens, nossa estimativa do Claude deu 409 e a regra do Google, 329 para o Gemini. O GPT-6 Luna saiu mais barato, com $0.000195 por pedido ($0.584 por mês); o Claude Opus 5.5 foi o mais caro, com $0.0119 por pedido ($35.81 por mês), cerca de 61 vezes mais.
Quanto custa um token em cada modelo?
Estes são preços de tabela em dólares americanos por 1 milhão de tokens, de entrada e de saída, para os 26 modelos de linguagem da calculadora, cada um tirado da página de preços do próprio fornecedor (uma exceção: a Meta não divulga preço de API para o Muse Spark Open, então a linha dele mostra o preço de endpoint listado pela Artificial Analysis). A maioria foi lida para o nosso ranking de modelos de IA em 18 de outubro de 2026; em 28 de outubro de 2026 relemos as páginas da OpenAI, da Anthropic e do Google e nada tinha mudado. A saída custa de 2 a 6 vezes o preço da entrada em todos os modelos daqui, então uma resposta longa custa mais que um prompt longo.
| Modelo | Entrada por 1M | Saída por 1M | Observações | Verificado | Fonte |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Entrada em cache a $1 por 1M de tokens. A entrada máxima é de 922,000 tokens da janela de 1,050,000 tokens. Acima de 272.000 tokens de entrada: $20 / $75 por 1M. | 18 de outubro de 2026 | developers.openai.com |
| GPT-5.5 | $5 | $30 | Acima de 272.000 tokens de entrada: $10 / $45 por 1M. | 28 de outubro de 2026 | developers.openai.com |
| GPT-6.1 Sol | $2 | $10 | Entrada em cache a $0.10 por 1M de tokens. Acima de 272.000 tokens de entrada: $4 / $15 por 1M. | 18 de outubro de 2026 | developers.openai.com |
| GPT-5.4 mini | $0.75 | $4.50 | 28 de outubro de 2026 | developers.openai.com | |
| GPT-4o mini | $0.15 | $0.60 | 28 de outubro de 2026 | developers.openai.com | |
| GPT-6 Luna | $0.10 | $0.50 | Entrada em cache a $0.01 por 1M de tokens. Acima de 272.000 tokens de entrada: $0.20 / $0.75 por 1M. | 18 de outubro de 2026 | developers.openai.com |
| Claude Fable 5.1 | $10 | $50 | Leituras do cache de prompt custam 2.5% do preço base de entrada; a Batch API tem 50% de desconto. | 18 de outubro de 2026 | platform.claude.com |
| Claude Opus 5.5 | $4 | $20 | Leituras de cache a $0.20 por 1M de tokens. O modo rápido (até 2.5x mais veloz) custa $8 de entrada / $40 de saída por 1M de tokens. | 18 de outubro de 2026 | platform.claude.com |
| Claude Sonnet 5.5 | $2 | $10 | Leituras do cache de prompt custam 5% do preço base de entrada; a Batch API tem 50% de desconto. | 18 de outubro de 2026 | platform.claude.com |
| Claude Haiku 5.5 | $0.10 | $0.50 | A Anthropic lista este como preço inicial ("a partir de"). Acima de 100.000 tokens de entrada: $0.50 / $2.50 por 1M. | 18 de outubro de 2026 | platform.claude.com |
| Gemini 4 Argon | $2 | $10 | Preço de lançamento até 30 de novembro de 2026; $4 de entrada / $20 de saída por 1M de tokens a partir de 1º de dezembro de 2026. A janela de contexto é compartilhada entre entrada e saída (até 1M de tokens de saída com decodificação longa). | 18 de outubro de 2026 | ai.google.dev |
| Gemini 3.8 Flash | $0.75 | $3.75 | Preço válido até 31 de dezembro de 2026; $1.50 de entrada / $7.50 de saída por 1M de tokens a partir de 1º de janeiro de 2027. | 18 de outubro de 2026 | ai.google.dev |
| Qwen3.8 Max | $2 | $6 | Alibaba Cloud Model Studio, preço de Singapura (internacional) para entradas de até 1M de tokens. | 18 de outubro de 2026 | alibabacloud.com |
| Qwen3.8 27B | $0.50 | $3 | Preço no Alibaba Cloud Model Studio (Singapura); os pesos têm download gratuito e podem ser hospedados por conta própria. | 18 de outubro de 2026 | alibabacloud.com |
| DeepSeek V4 Pro | $1.32 | $3.96 | Preço no horário de pico; fora do pico as tarifas são metade ($0.66 / $1.98). Entrada com acerto de cache a $0.044 no pico. | 18 de outubro de 2026 | api-docs.deepseek.com |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | Preço no horário de pico; fora do pico as tarifas são metade ($0.15 / $0.60). Entrada com acerto de cache a $0.006 no pico. | 18 de outubro de 2026 | api-docs.deepseek.com |
| Muse Wonder | $4 | $20 | ID do modelo na API: muse-wonder-1.0; entrada em cache a $0.20 por 1M de tokens. O Muse Wonder Full, mais forte, só está incluído nas assinaturas do Muse Code. | 18 de outubro de 2026 | dev.meta.ai |
| Muse Spark 1.3 | $1.25 | $4.25 | ID do modelo: muse-spark-1.3; entrada em cache a $0.15. Uma variante muse-spark-1.3-contributor ($0.10 / $0.20) pode ser usada para melhorar produtos da Meta. | 18 de outubro de 2026 | dev.meta.ai |
| Muse Spark Open | $1.25 | $4.25 | Pesos abertos (repositório no Hugging Face meta-models/Muse-Spark-Open-816B-A42B). A Meta não lista preço por token; este é o preço do endpoint mostrado pela Artificial Analysis. | 18 de outubro de 2026 | artificialanalysis.ai |
| MiniMax-M3 | $0.30 | $1.20 | Preço padrão com desconto para prompts de até 512K tokens (preço de tabela $0.60 / $2.40); $0.60 / $2.40 acima de 512K tokens. | 18 de outubro de 2026 | platform.minimax.io |
| Mistral Large 4 | $1.36 | $4.18 | Preço normal; a Mistral mostrava uma promoção de lançamento pela metade do preço ($0.68 / $2.09, entrada em cache a $0.07) na época deste levantamento. | 18 de outubro de 2026 | docs.mistral.ai |
| Kimi K3 | $3 | $15 | Entrada com acerto de cache a $0.30 por 1M de tokens; gravações em cache a $3 (TTL de 5 minutos) ou $6 (TTL de 1 hora). | 18 de outubro de 2026 | platform.kimi.ai |
| Grok 4.7 | $2 | $6 | Para prompts abaixo de 200K tokens. Prompts de 200K tokens ou mais são cobrados a $4 de entrada / $12 de saída por 1M de tokens. Entrada em cache a $0.50. | 18 de outubro de 2026 | docs.x.ai |
| MiMo-V2.6-Pro | $0.435 | $0.87 | Preço da API em tempo real para fora da China; entrada com acerto de cache a $0.0036 por 1M de tokens. Um nível mais rápido, UltraSpeed, custa 10x mais. | 18 de outubro de 2026 | mimo.mi.com |
| GLM-5.3 | $1.40 | $4.40 | Entrada em cache a $0.26 por 1M de tokens. A Z.ai também vende uma assinatura GLM Coding Plan. | 18 de outubro de 2026 | docs.z.ai |
| GLM-5.3-Flash | $0.15 | $0.50 | Entrada em cache a $0.03 por 1M de tokens. | 18 de outubro de 2026 | docs.z.ai |
A calculadora usa só preços de tabela. O processamento em lote custa metade na Anthropic e na OpenAI, cuja página de preços lista as tarifas em lote pela metade das normais para os modelos GPT-6, e a entrada em cache custa uma fração do preço de tabela, então uma conta real pode sair menor.
Como reduzir o custo dos tokens?
Cinco hábitos fazem a maior parte do trabalho, e cada um aparece na calculadora: mude o tamanho da resposta, o modelo ou o texto e veja o valor mensal mudar.
- Use cache para o que se repete. Se os seus pedidos começam com as mesmas instruções ou o mesmo documento, o prompt caching cobra a repetição por uma fração do preço de entrada: 5% no Claude Opus 5.5 e no Sonnet 5.5 (Anthropic), e $0.10 em vez de $2 por milhão de tokens no GPT-6.1 Sol (OpenAI). O Claude Code já faz isso: mesmo com as ferramentas desligadas, ele mandou de 3.200 a 4.000 tokens de instruções próprias em cada pedido de uma linha no nosso teste, e depois do primeiro pedido a maior parte foi contada como leitura de cache.
- Mande em lote o que pode esperar. Relatórios, classificação e resumos que podem chegar em algumas horas custam metade pela Batch API da Anthropic e pelas tarifas em lote da OpenAI.
- Teste primeiro o modelo menor. O Claude Haiku 5.5 custa $0.10 / $0.50 por milhão de tokens contra $4 / $20 do Claude Opus 5.5, 40 vezes menos. Rode alguns dos seus pedidos reais nos dois antes de ficar com o grande.
- Fique abaixo da linha dos prompts longos. O Claude Haiku 5.5 cobra 5 vezes mais por prompts acima de 100.000 tokens, e os modelos GPT-6 cobram o dobro na entrada e 1,5 vez na saída acima de 272.000 tokens de entrada. Cole a parte do documento de que a tarefa precisa, não o arquivo inteiro, e corte o histórico antigo do chat.
- Peça respostas mais curtas. A saída custa de 2 a 6 vezes o preço da entrada, então diga o tamanho que você quer ("três tópicos") e defina um máximo de saída na API. Modelos que pensam antes de responder também cobram esse raciocínio como saída: a página de preços do Google chama o preço de saída de "including thinking tokens" (incluindo os tokens de raciocínio).
Se você usa o Claude Code numa assinatura e não pela API, os tokens aparecem como limites de uso em vez de conta; nosso guia de limites de uso do Claude Code explica os limites de 5 horas e semanais e como fazê-los render.
Perguntas frequentes
Quantos tokens são 1.000 palavras?
No nosso teste, 1.000 palavras em português deram cerca de 1.200 tokens no tokenizador da OpenAI e cerca de 2.200 no Claude; em inglês, cerca de 1.100 e 1.700. Espanhol e francês ficaram perto do português (de 1.200 a 1.300 tokens da OpenAI e de 2.100 a 2.300 do Claude). A regra do Google para o Gemini dá cerca de 1.400 tokens em português e em inglês.
Por que o Claude conta mais tokens que o GPT para o mesmo texto?
Cada empresa treina o próprio tokenizador, e o do Claude corta o texto em pedaços menores: no nosso teste ele precisou de 1,28 a 1,78 vez os tokens da OpenAI para o mesmo texto (1,78 em português). Por isso, compare o custo por pedido na calculadora, não o preço por token: um preço por token menor ainda pode virar uma conta maior.
A contagem de tokens é igual ao que eu pago?
Chega perto, mas a API também conta o que envolve o seu texto: o prompt de sistema, as definições de ferramentas e a formatação das mensagens. Modelos que raciocinam ainda cobram esse raciocínio como saída. No nosso teste com o Claude Code, um prompt de uma palavra somou 3.998 tokens de entrada; os números de uso em cada resposta da API são a conta real.
Esta calculadora de tokens envia meu texto para algum lugar?
Não. A contagem e a conta do custo rodam no seu navegador, e a ferramenta fica oculta para a análise de uso do site (Microsoft Clarity), então seu texto não é gravado. O único download é o arquivo do tokenizador da OpenAI, de cerca de 1 MB, baixado do nosso próprio site na primeira vez que você digita.
Como consigo uma contagem exata do Claude ou do Gemini?
Use o contador do próprio fornecedor. O endpoint de contagem de tokens da Anthropic é gratuito com uma chave de API, e a API do Gemini tem uma chamada countTokens; os dois contam com o tokenizador do modelo que você indicar. Sem chave, as proporções que medimos aqui são a estimativa mais próxima.