Claude Code com Ollama: modelos locais grátis (guia 2026)
Quatro passos para rodar o Claude Code num modelo aberto e grátis com o Ollama, o modelo que cabe no seu computador e o que medimos num Mac de 48 GB.
Por Yotam DahanAtualizado 21 min de leituraClaude Code
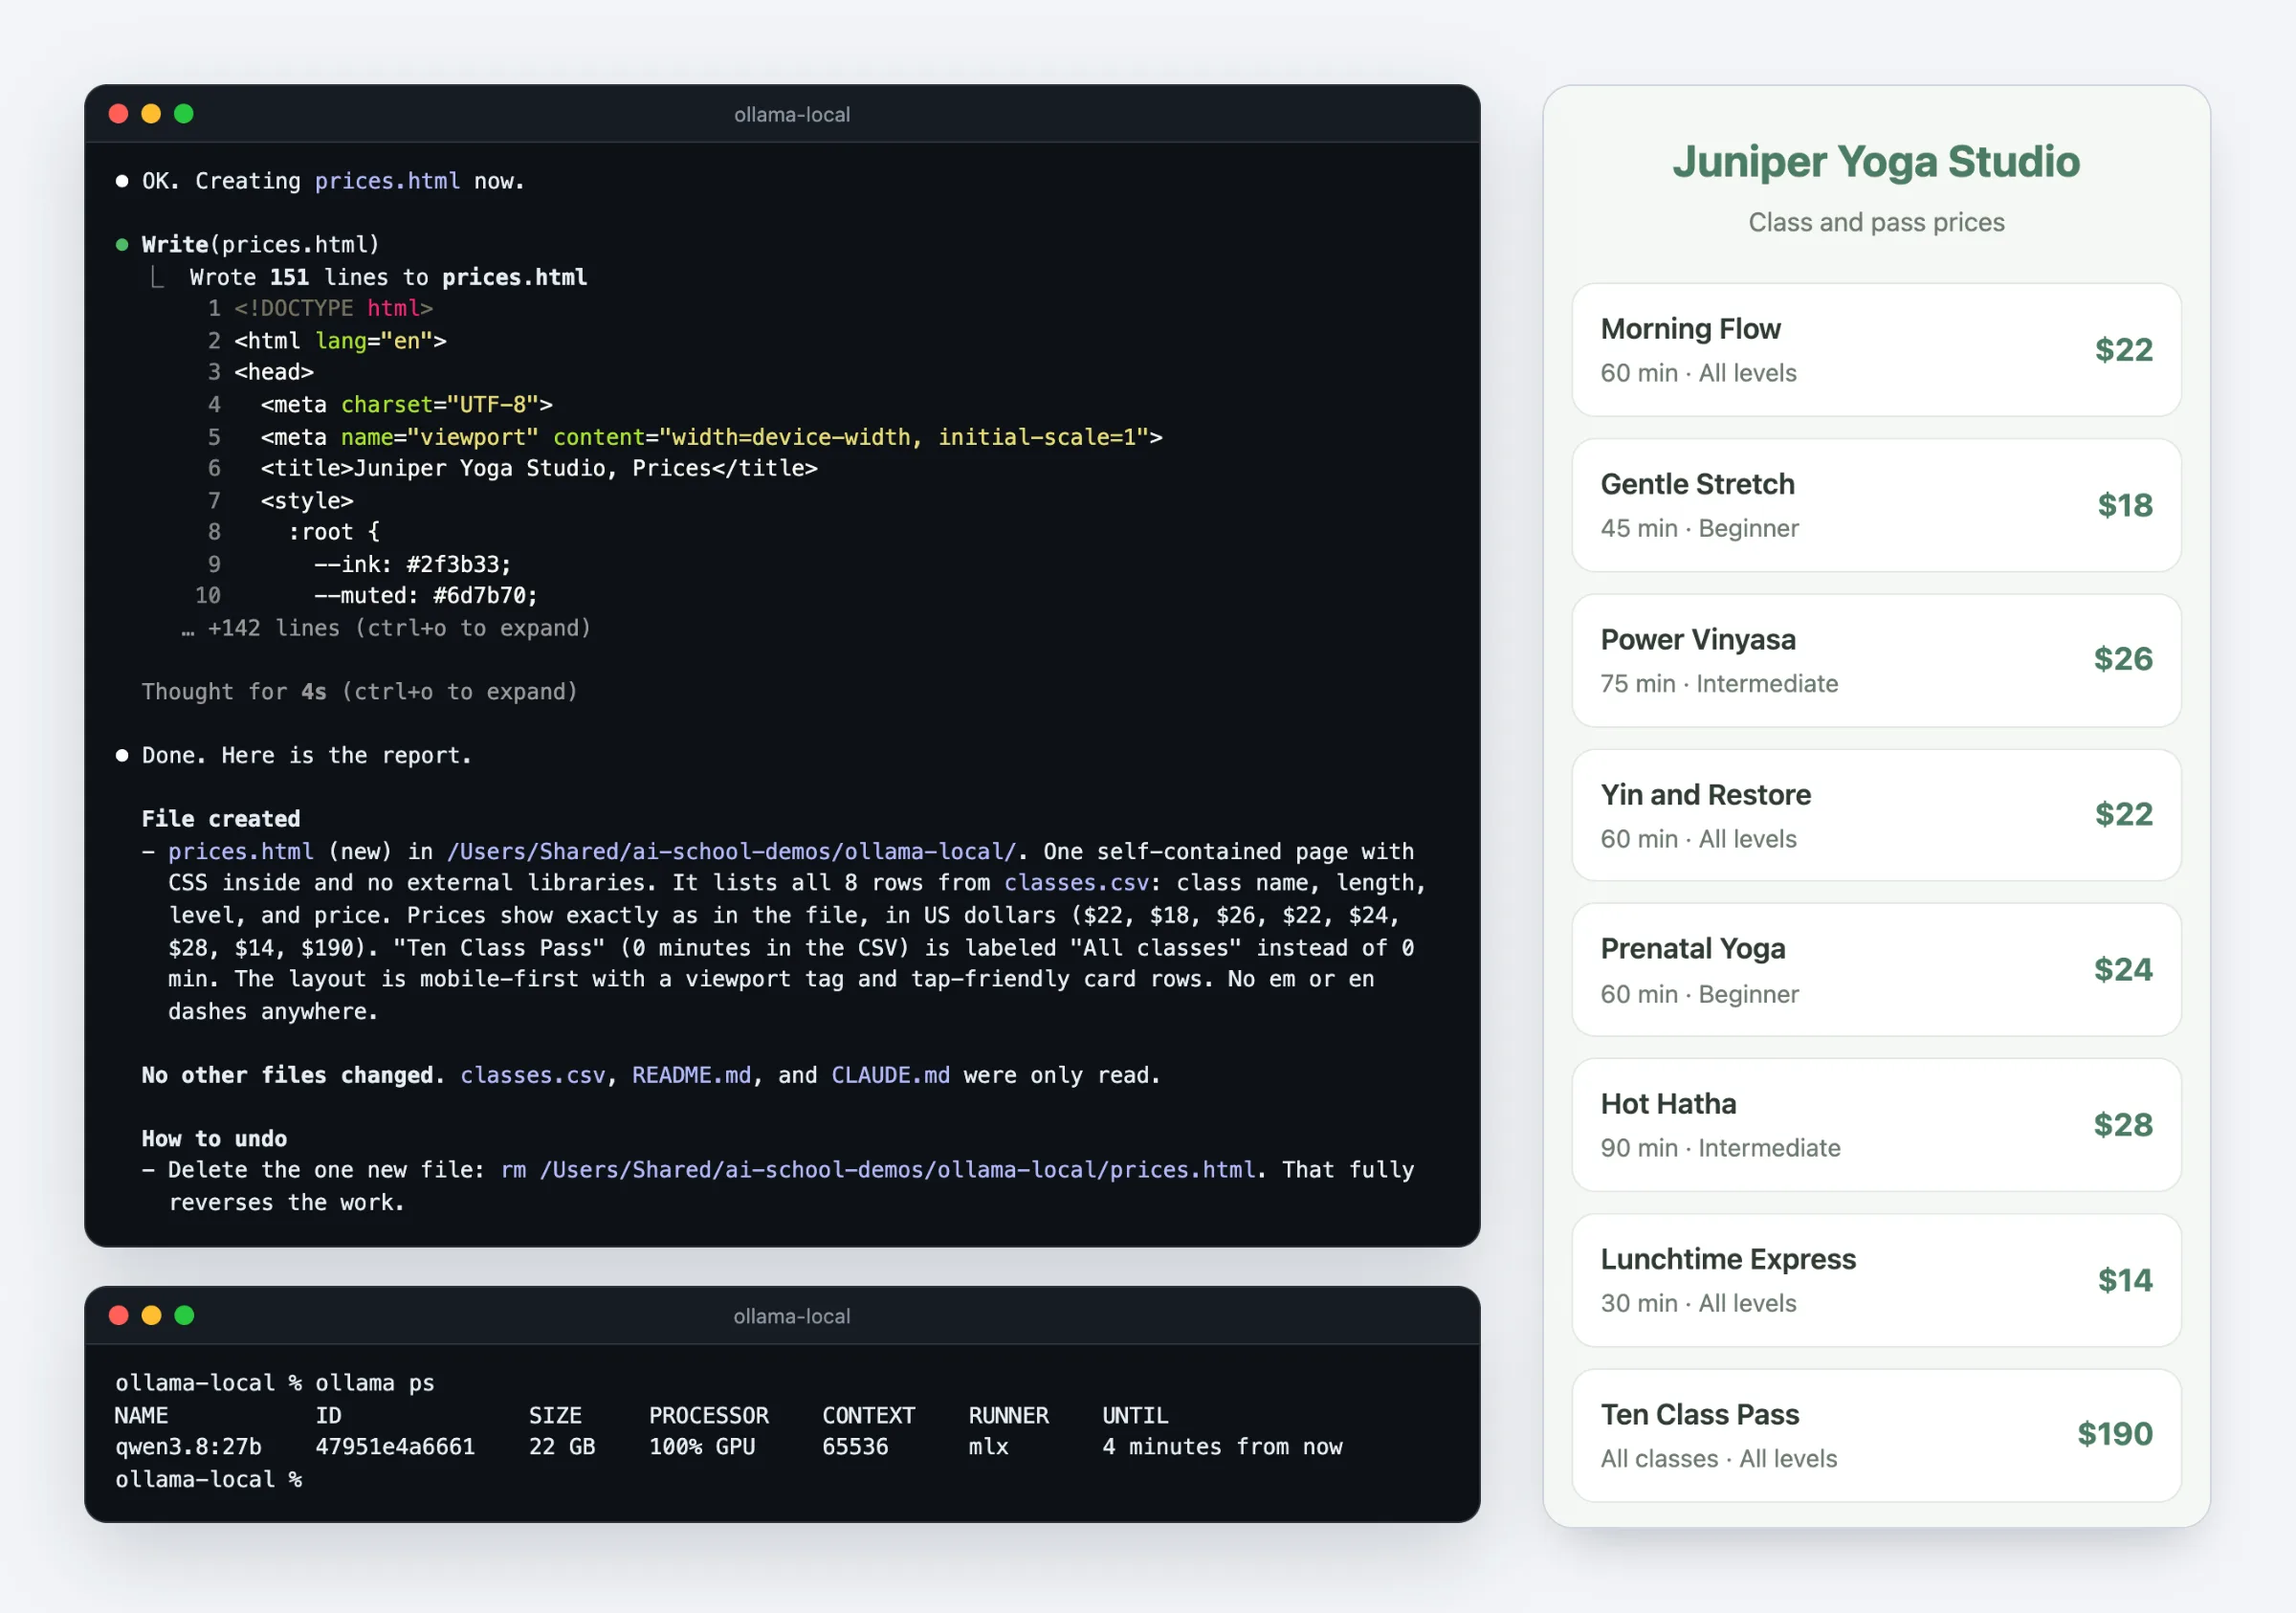
O Claude Code com Ollama roda o Claude Code num modelo aberto e gratuito no seu próprio computador, em vez do Claude: instale o Ollama, aumente o tamanho de contexto dele para 64K e rode ollama launch claude. Funciona, mas a configuração é do Ollama, não da Anthropic: a Anthropic não dá suporte ao Claude Code com modelos que não são do Claude, e um modelo local é bem mais fraco e mais lento que o Claude. Use para experimentos privados e trabalhos simples, não como substituto direto de um plano do Claude.
Como o Claude Code roda no Ollama
O Claude Code é o agente: o programa que lê os seus arquivos, roda comandos e pergunta antes de mudar qualquer coisa. O modelo é o cérebro por trás dele, normalmente o Claude, nos servidores da Anthropic.
Desde a versão 0.14.0, de janeiro de 2026 (segundo as notas de versão do Ollama), o Ollama responde no mesmo formato de mensagens da API da Anthropic, no seu próprio computador, na porta 11434. Aponte o Claude Code para lá e ele funciona com um modelo aberto (que qualquer pessoa pode baixar e rodar). O Claude Code em si não muda e continua sob os termos da Anthropic, seja qual for o modelo por trás.
Quem pesquisa "claude code ollama", "ollama claude code" ou "claude code ollama local" está atrás exatamente disto: o Claude Code de sempre, conversando com um modelo que roda no Ollama.
Você
Pede uma mudança ao Claude Code com as suas palavras, em português
Claude Code
Lê os seus arquivos e manda o pedido para o Ollama na porta 11434
Ollama
Roda o modelo aberto no chip gráfico do seu computador
Os seus arquivos
O Claude Code aplica as edições que o modelo pede, com a sua permissão
O que você precisa
A memória decide quase tudo: o modelo precisa caber na memória que o chip gráfico pode usar, com espaço para a conversa, ou fica lentíssimo. Você não precisa de plano do Claude nem de chave de API, e o Ollama pode instalar o Claude Code para você (ou veja como instalar o Claude Code). O melhor modelo do Ollama para Claude Code depende da sua memória, então comece por aqui:
| O seu computador | Comece com | Download | Memória indicada pelo Ollama |
|---|---|---|---|
| 16 GB ou menos | qwen3.5:4b | 3,3 a 4,0 GB | Cerca de 6 GB |
| 24 a 32 GB | gemma4:12b | 7,7 a 8,0 GB | Cerca de 11 GB |
| 48 GB ou mais | qwen3.8:27b | 18 GB | Cerca de 28 GB |
| Qualquer computador, com conta no ollama.com | gemma4:cloud | Nada | Roda nos servidores do Ollama |
As indicações de memória são as que o launcher do Ollama (o comando ollama launch) mostra, e os tamanhos de download vêm da biblioteca do Ollama, ambos conferidos em 22 de outubro de 2026. Num PC, compare a indicação com a memória da sua placa de vídeo. O app para Mac tem cerca de 214 MB.
Passo 1: instale o Ollama no Mac, no Windows ou no Linux
Instalar Claude Code com Ollama começa pelo próprio Ollama: o instalador em ollama.com/download traz um app que roda um pequeno servidor em segundo plano, mais o comando ollama.
- Mac (macOS 14 ou mais novo): baixe o Ollama.dmg, arraste o Ollama para Aplicativos e abra; ele oferece adicionar o comando
ollamaao seu terminal. - Windows 10 (22H2) ou 11: rode o OllamaSetup.exe, que não pede direitos de administrador.
- Linux: rode o script de instalação abaixo; ele configura o Ollama como um serviço em segundo plano.
- Confira: abra uma janela nova do terminal e rode
ollama -v.
Os instaladores oficiais de uma linha, para Mac ou Linux:
curl -fsSL https://ollama.com/install.sh | sh
No Windows, no PowerShell:
irm https://ollama.com/install.ps1 | iex
ollama -v
ollama version is 0.40.8
No Windows, placas NVIDIA precisam do driver 551.61 ou mais novo, e placas AMD Radeon rodam via ROCm ou Vulkan, segundo a documentação do Ollama para Windows.
Passo 2: ajuste o tamanho de contexto para 64K
O tamanho de contexto (context length) é quanto da conversa o modelo consegue ver de uma vez, medido em tokens (pequenos pedaços de texto). Só o pedido de abertura do Claude Code, com as instruções dele mais a descrição de cada ferramenta, deu cerca de 20.300 tokens nos nossos testes, sem plugins, e há usuários relatando até 36.000. Por isso o Ollama pede 64K.
O Ollama escolhe um padrão a partir da sua memória de vídeo, e a maioria dos computadores fica abaixo disso. No Mac, ele conta a parte da memória que o chip gráfico pode usar, e o log do nosso MacBook Pro de 48 GB mostra o resultado: vram-based default context total_vram="37.4 GiB" default_num_ctx=32768, ou seja, 32K.
é o padrão abaixo de 24 GB de memória de vídeo
é o padrão de 24 a 48 GB, incluindo o nosso Mac de 48 GB
é o padrão a partir de 48 GB
é o que o Ollama pede para o Claude Code
Faixas da documentação de tamanho de contexto do Ollama, conferida em 22 de outubro de 2026. Os 32K do nosso Mac vêm do próprio log do Ollama.
Dá para aumentar o contexto do Ollama para o Claude Code de quatro jeitos, todos do lado do Ollama:
- O app do Ollama (Mac e Windows): abra Settings (configurações) e ajuste Context length para 64k, que o app salva como 65.536 tokens.
- Um terminal, com o app fechado: rode
OLLAMA_CONTEXT_LENGTH=65536 ollama servee deixe a janela aberta (foi o que fizemos). - Um serviço no Linux: rode
sudo systemctl edit ollama, acrescente as duas linhas abaixo e reinicie o serviço. - Um modelo só, em qualquer sistema: salve uma cópia do modelo com uma janela maior e use o nome novo (aqui,
qwen3.8-64k) no lugar deqwen3.8:27b.
[Service]
Environment="OLLAMA_CONTEXT_LENGTH=65536"sudo systemctl daemon-reload && sudo systemctl restart ollama
Para a cópia, coloque estas duas linhas num arquivo de texto simples chamado Modelfile (o Bloco de Notas serve) e crie o modelo a partir dessa pasta:
FROM qwen3.8:27b
PARAMETER num_ctx 65536ollama create qwen3.8-64k -f Modelfile
Depois, carregue um modelo e confira o que o Ollama realmente deu a ele:
ollama ps
NAME ID SIZE PROCESSOR CONTEXT RUNNER UNTIL
qwen3.8:27b 47951e4a6661 22 GB 100% GPU 65536 mlx 4 minutes from now
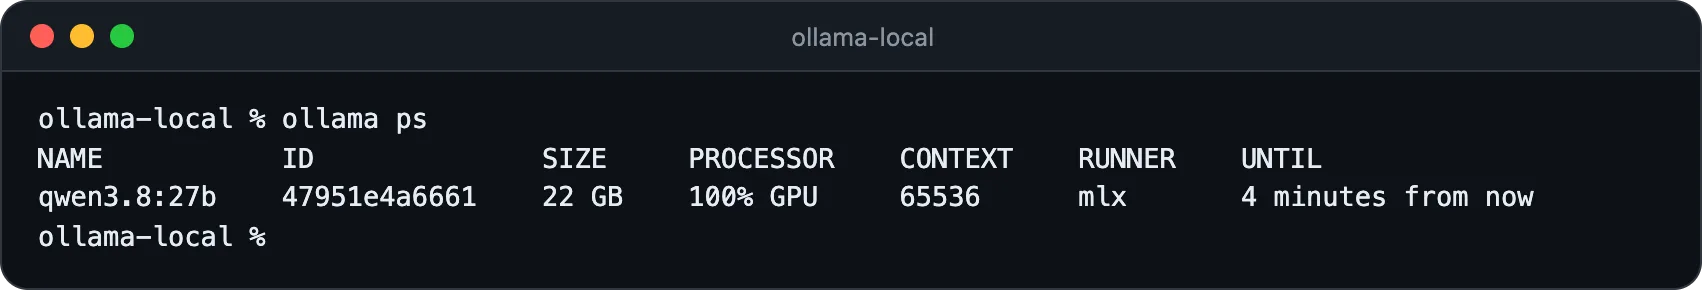
A coluna CONTEXT deve mostrar 64K ou mais, e a PROCESSOR, 100% GPU; uma divisão como 48%/52% CPU/GPU quer dizer que parte do modelo foi parar numa memória mais lenta. No Mac, RUNNER mlx indica o motor MLX da Apple.
Passo 3: abra o Claude Code com ollama launch claude
Abra um terminal na pasta em que o Claude Code vai trabalhar (o Terminal no Mac, o PowerShell no Windows) e rode:
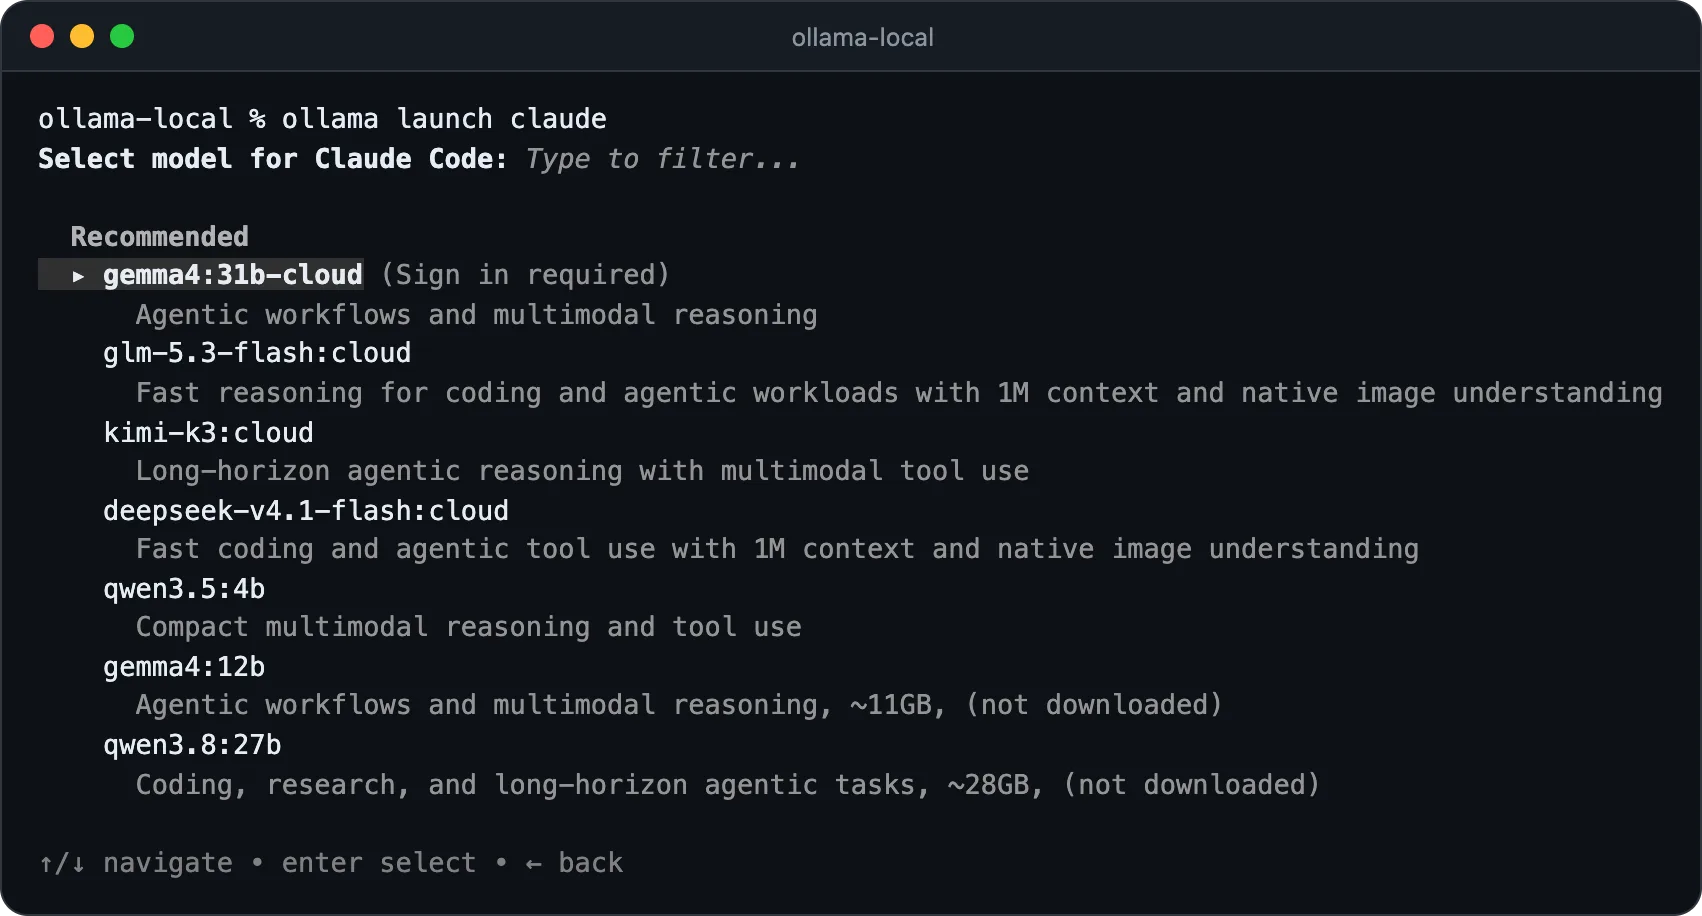
ollama launch claude
- Escolha um modelo. Em "Recommended" (recomendados), a lista mostra primeiro os modelos na nuvem do Ollama (eles exigem login no ollama.com) e depois os locais, com a memória de que precisam, marcados como "not downloaded" (não baixado) até você ter cada um.
- Deixe baixar. Se o modelo ainda não está no seu computador, o Ollama baixa antes. O qwen3.8:27b, de 18 GB, levou 6 minutos e 43 segundos na nossa conexão.
- Instale o Claude Code se ele pedir. Se o Claude Code não estiver instalado, o Ollama pergunta "Claude Code is not installed. Install now?" (o Claude Code não está instalado, instalar agora?) e roda o instalador oficial da Anthropic.
- Confie na pasta. Na primeira vez que abre, o Claude Code pergunta o tema e se você confia na pasta, sem tela de login. Depois, o cabeçalho mostra o modelo que responde:
qwen3.8:27b · API Usage Billing.
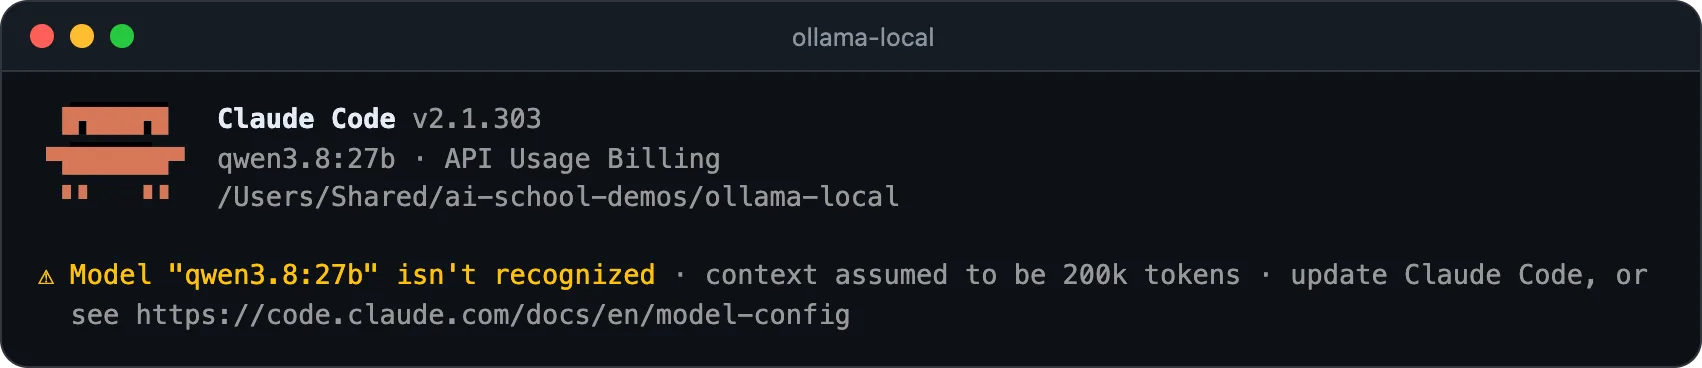
Essa linha amarela importa: o Claude Code conhece o tamanho de contexto dos modelos do Claude, mas não o do qwen3.8:27b, então mostrou Model "qwen3.8:27b" isn't recognized · context assumed to be 200k tokens (modelo não reconhecido, contexto presumido de 200k tokens), como descreve a documentação de configuração de modelos da Anthropic. Com isso, ele esperaria tempo demais para compactar (resumir) uma conversa longa. Abra com um tamanho um pouco abaixo do que o Ollama usa e o aviso some:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000 ollama launch claude --model qwen3.8:27b
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
ollama launch claude --model qwen3.8:27b
Só para essa sessão, o launcher aponta o Claude Code para o Ollama com um token provisório, então não precisa de login do Claude, e coloca o seu modelo no lugar de todos os modelos que o Claude Code usaria, inclusive o dos agentes auxiliares. Ele não grava nenhuma configuração do Claude Code: um claude simples numa janela nova volta para o seu plano do Claude. O --yes (junto com --model) pula todas as perguntas, e tudo o que vem depois de -- vai para o Claude Code, como em ollama launch claude --model qwen3.8:27b -- --resume.
O caminho manual: variáveis de ambiente
Para abrir o claude simples, defina as variáveis você mesmo. A documentação do Claude Code do Ollama lista as três primeiras; as linhas de modelo são o que o launcher acrescenta, porque sem elas alguns ajudantes do Claude Code pedem ao Ollama um modelo do Claude e recebem "model not found" (modelo não encontrado). No Mac ou no Linux:
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3.8:27b
export CLAUDE_CODE_SUBAGENT_MODEL=qwen3.8:27b
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000
claude --model qwen3.8:27b
No Windows, no PowerShell:
$env:ANTHROPIC_BASE_URL = "http://localhost:11434"
$env:ANTHROPIC_AUTH_TOKEN = "ollama"
Remove-Item Env:ANTHROPIC_API_KEY -ErrorAction SilentlyContinue
$env:ANTHROPIC_DEFAULT_OPUS_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_SONNET_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_HAIKU_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_SUBAGENT_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
claude --model qwen3.8:27b
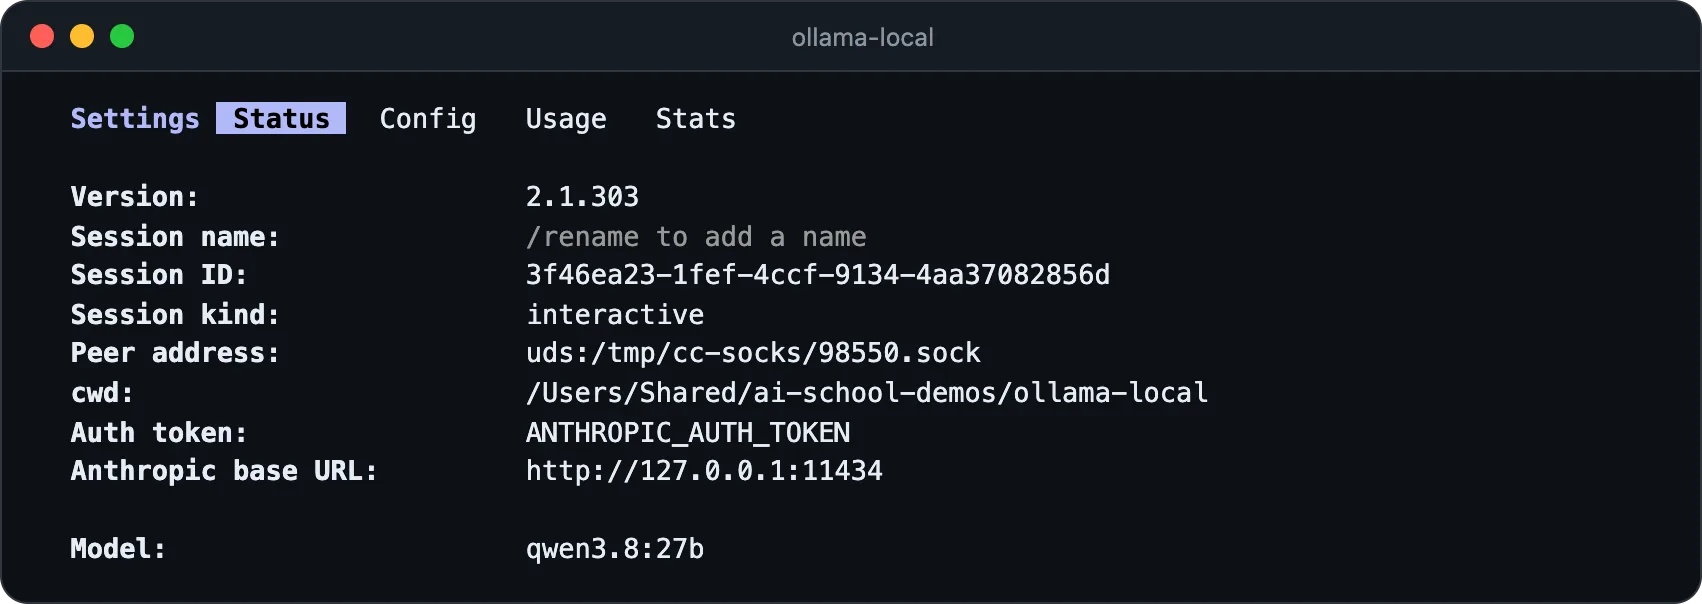
O PowerShell não guarda uma variável vazia, então a versão para Windows remove a variável ANTHROPIC_API_KEY, com o mesmo efeito. As configurações valem até você fechar a janela. Para conferir qualquer um dos dois caminhos, digite /status: a linha do auth token deve citar ANTHROPIC_AUTH_TOKEN, e a base URL deve ser o seu próprio computador, na porta 11434.
Os melhores modelos do Ollama para o Claude Code
Os modelos do Ollama que o launcher recomenda para o Claude Code mudam com o tempo. Em 22 de outubro de 2026, as escolhas locais eram as três da tabela lá em cima: todas sabem chamar ferramentas, algo de que o Claude Code depende (ler um arquivo, editar, rodar um comando), todas chegam a um contexto máximo de 256K e todas usam a licença Apache 2.0. As escolhas na nuvem:
| Modelo na nuvem | Contexto | Plano |
|---|---|---|
gemma4:cloud | 256K | Créditos iniciais do plano Free |
glm-5.3-flash:cloud | 1M | Pro ou créditos comprados |
kimi-k3:cloud | 1M | Pro ou créditos comprados |
deepseek-v4.1-flash:cloud | 1M | Pro ou créditos comprados |
Agora a parte honesta. O Terminal-Bench 4.0 é um conjunto de tarefas reais de terminal que a Artificial Analysis roda do mesmo jeito para todos os modelos:
Da Artificial Analysis, conferido em 22 de outubro de 2026. São os modelos completos, hospedados na nuvem; não espere que as versões comprimidas que você baixa num notebook se saiam melhor. O Gemma 4 não tem nota nesse teste.
O GLM-5.3-Flash e o DeepSeek V4.1 Flash, ambos na nuvem do Ollama, marcam cerca de seis vezes o que o Qwen3.8 27B marca, e o Claude continua muito à frente de todos eles. O nosso ranking de modelos de IA mostra o quadro mais amplo.
O que vimos num Mac de 48 GB
Para ver a diferença num trabalho pequeno e real, entreguei aos dois modelos locais a lista de aulas de um estúdio de yoga de demonstração e o prompt de teste do nosso guia de agentes de IA para programar, que você pode rodar nos seus próprios arquivos:
Trabalhe só dentro desta pasta. Leia [ARQUIVO COM OS SEUS PREÇOS OU SERVIÇOS] e crie uma lista de preços de uma página chamada precos.html que fique boa no celular. Antes de mudar qualquer coisa, me conte o seu plano em três tópicos e espere o meu OK. Quando terminar, liste cada arquivo que você criou ou alterou e como eu desfaço isso.| Modelo e contexto | Primeira resposta depois de | Tarefa inteira | A página funcionou? | Erros de ferramenta |
|---|---|---|---|---|
| qwen3.8:27b, 64K | 3 min 27 s | 5 min 30 s | Sim | 0 |
| qwen3.5:4b, 64K | 43 s | 1 min 39 s | Em parte | 0 |
| qwen3.5:4b, padrão de 32K, primeira execução | 7 min 10 s, depois de um erro de API | 8 min 7 s | Em parte | 0, mais 1 nova tentativa automática |
tokens por segundo escritos pelo qwen3.8:27b
tokens por segundo escritos pelo qwen3.5:4b
tokens por segundo, aproximadamente, lidos pelo qwen3.8:27b
de memória usada pelo qwen3.8:27b depois da tarefa
As nossas medições num MacBook Pro com M4 Pro e 48 GB, Ollama 0.40.8, 22 de outubro de 2026. As velocidades de escrita são de execuções já aquecidas do ollama run --verbose; a de leitura vem do log do Ollama para o pedido de abertura do Claude Code. Os tempos contam o trabalho do modelo, não a nossa digitação.
O qwen3.8:27b acertou: página limpa, os oito preços exatos, um plano correto e nenhum erro de ferramenta. A primeira resposta levou 3 minutos e 27 segundos porque ele leu o pedido de abertura do Claude Code, de 20.300 tokens, a cerca de 117 tokens por segundo; depois, o cache do Ollama deixou cada passo rápido.
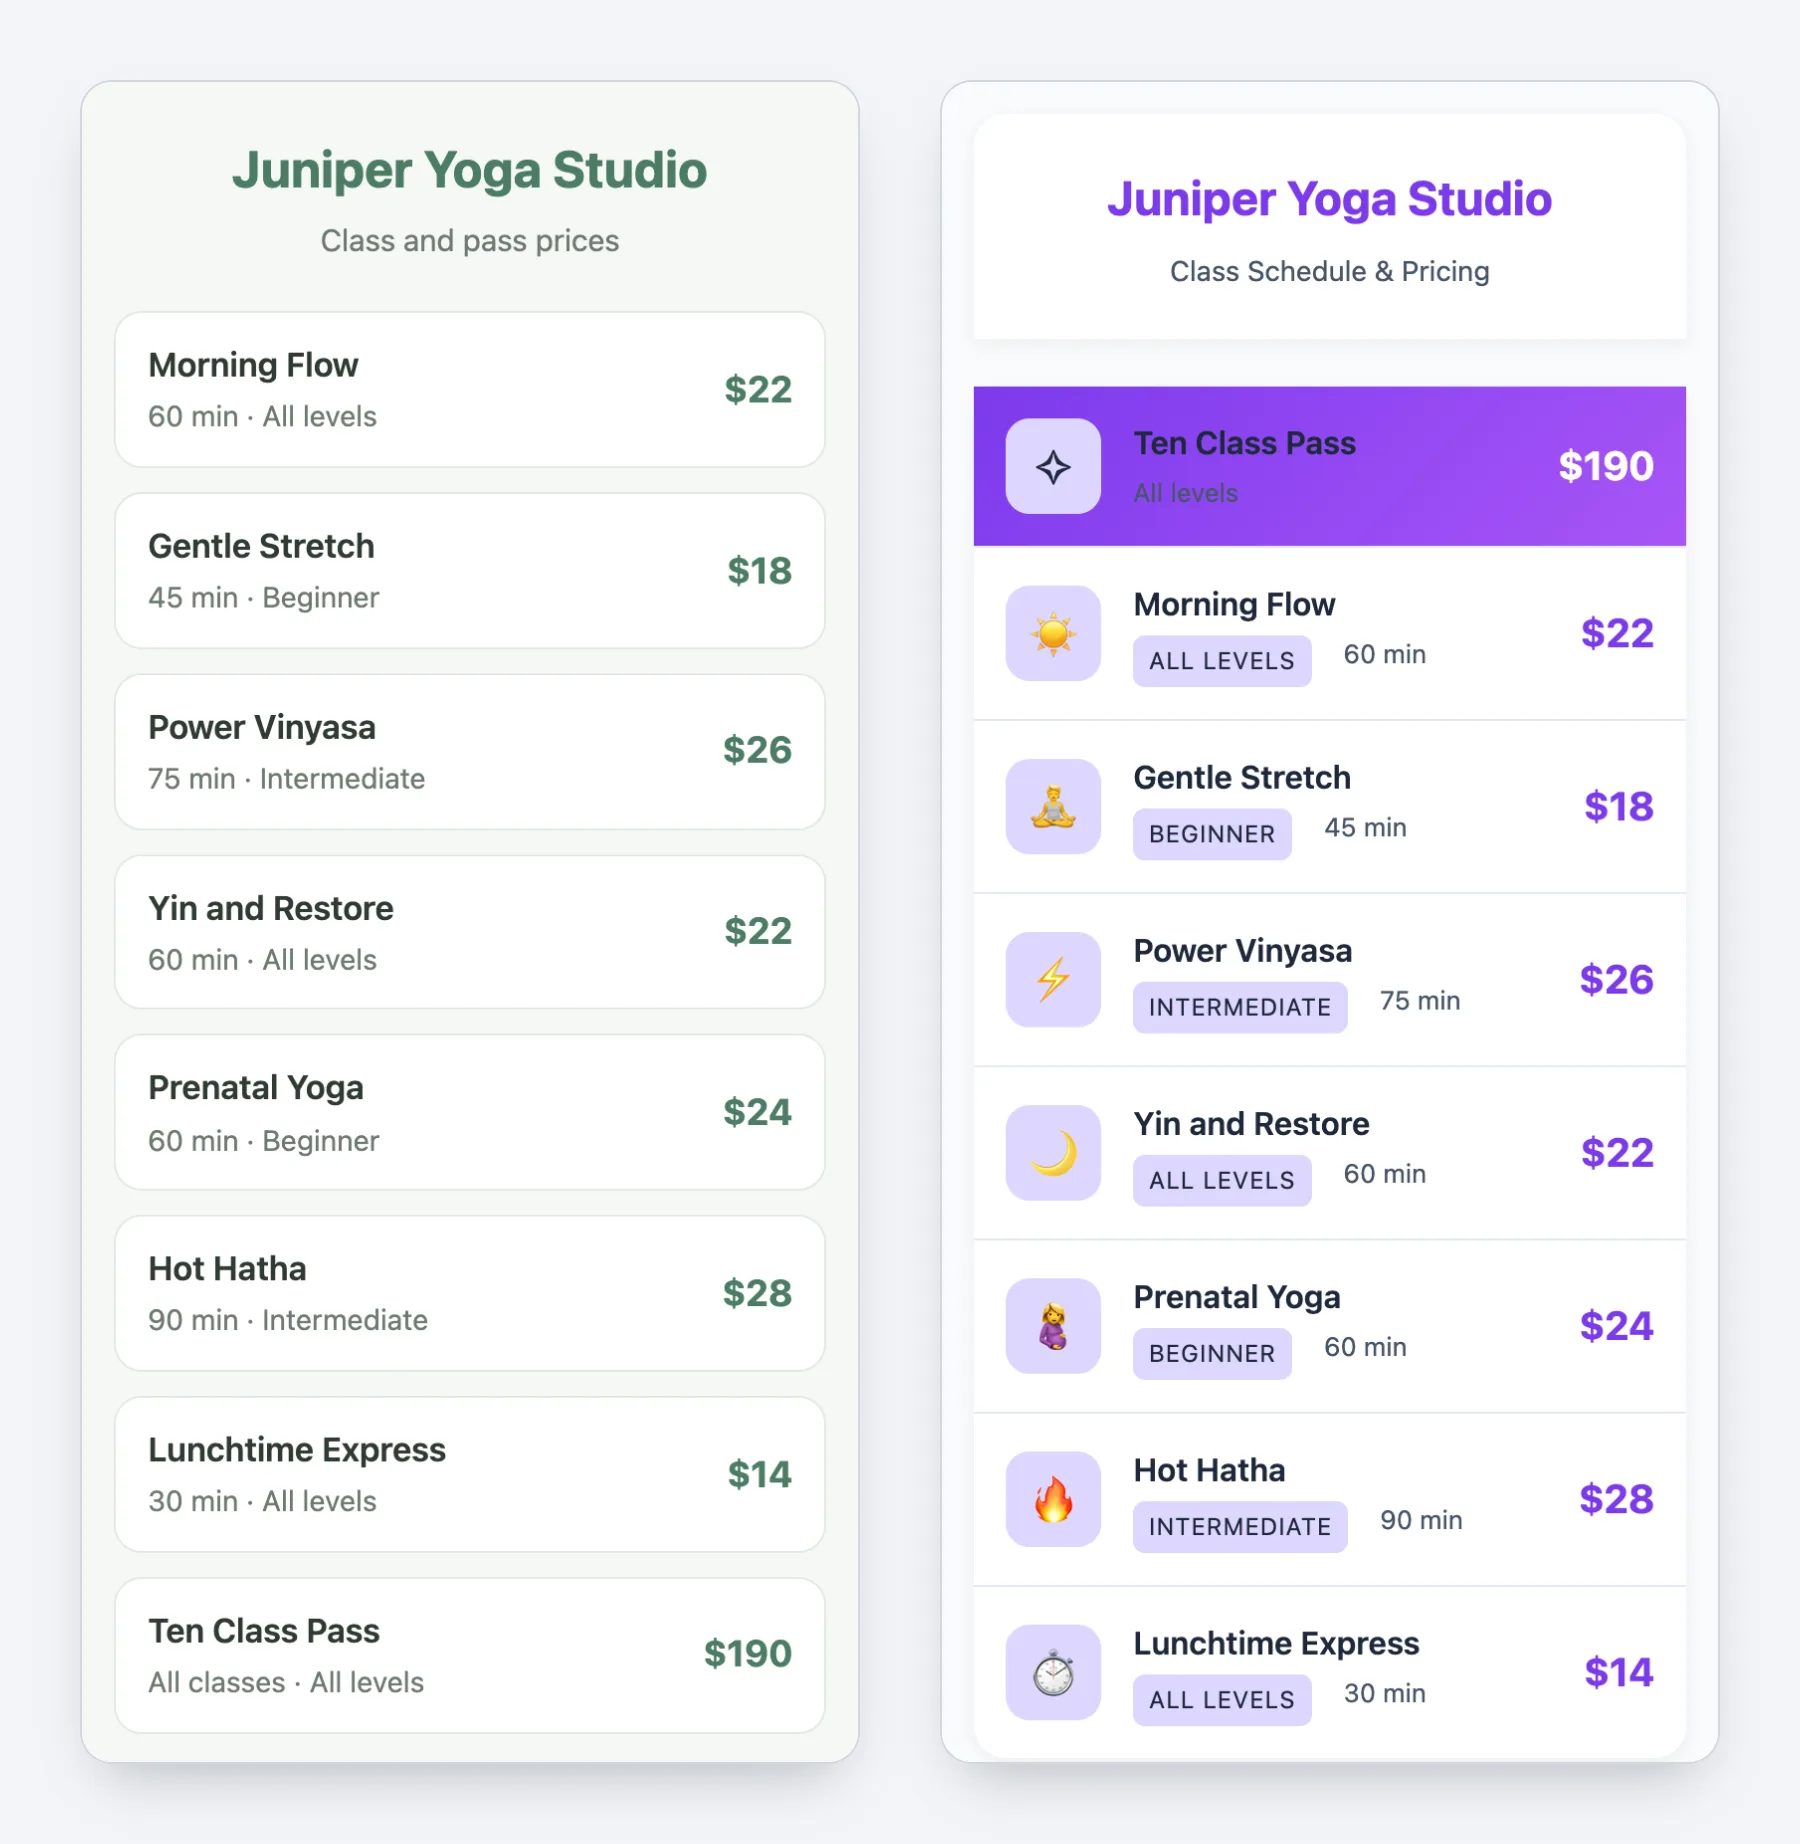
O qwen3.5:4b leu o mesmo pedido em cerca de 28 segundos e terminou em menos de dois minutos, mas é uma demonstração rápida, não um trabalhador confiável: preços certos, uma linha difícil de ler e um travessão (em dash) na resposta, que o CLAUDE.md da pasta proíbe. Na primeira execução, com o padrão de 32K, o plano dele cobrou US$ 29 por uma aula (o arquivo diz US$ 28), depois disto:
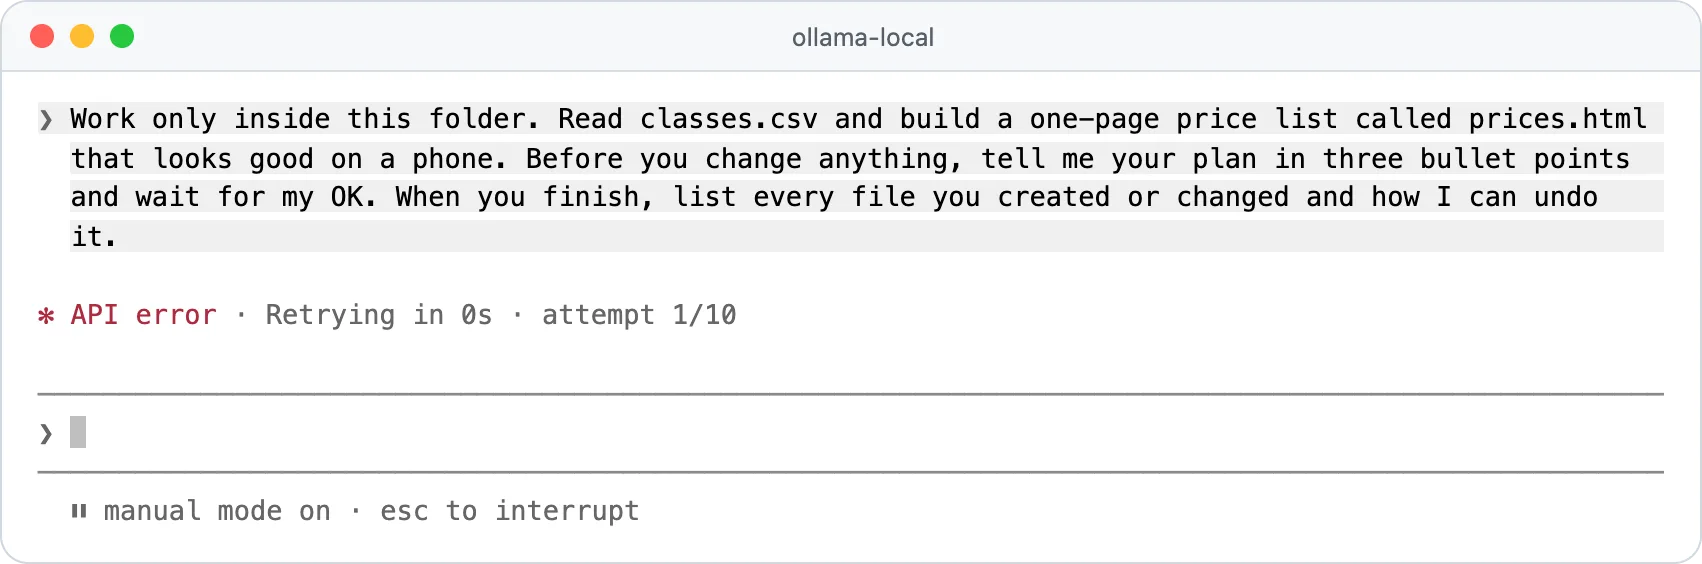
O Ollama mandou um erro HTTP 500 depois de 5 minutos e 22 segundos, enquanto o modelo ainda estava ocupado com um pequeno pedido paralelo; o Claude Code mostrou API error · Retrying in 0s · attempt 1/10 e tentou de novo por conta própria. Não consertamos nada à mão em nenhuma execução.
O que para de funcionar sem o Claude
O agente é o mesmo programa, então a maior parte do Claude Code continua funcionando. Muda o que depende dos servidores da Anthropic ou de um login do Claude, e é aí que o Claude Code grátis com Ollama mostra os seus limites:
Funciona
Ler e editar arquivos, rodar comandos com a sua permissão, planos que você aprova e agentes auxiliares, que o Ollama suporta.
Muda
A pesquisa na web do próprio Claude fica desligada. Com os modelos na nuvem do Ollama, a pesquisa na web do Ollama entra no lugar, e ela exige conta no ollama.com.
Desaparece
Remote Control, ditado por voz, sessões na nuvem e a aba Code do app de desktop, que exigem login do Claude.
Mais limitado
Sem o cache de prompts da Anthropic, contagens de tokens estimadas no /context, sem leitura de PDF e um modelo que pode ignorar as regras do seu CLAUDE.md.
Fontes: a página de disponibilidade de recursos da Anthropic e a lista de compatibilidade com a API da Anthropic do Ollama.
Modelos na nuvem do Ollama para o Claude Code
Os modelos que terminam em :cloud rodam nos servidores do Ollama: nada para baixar, nenhum chip gráfico forte e notas bem mais altas. O porém: eles exigem conta no ollama.com (ollama signin), e os seus prompts saem do seu computador.
ollama launch claude --model gemma4:cloud
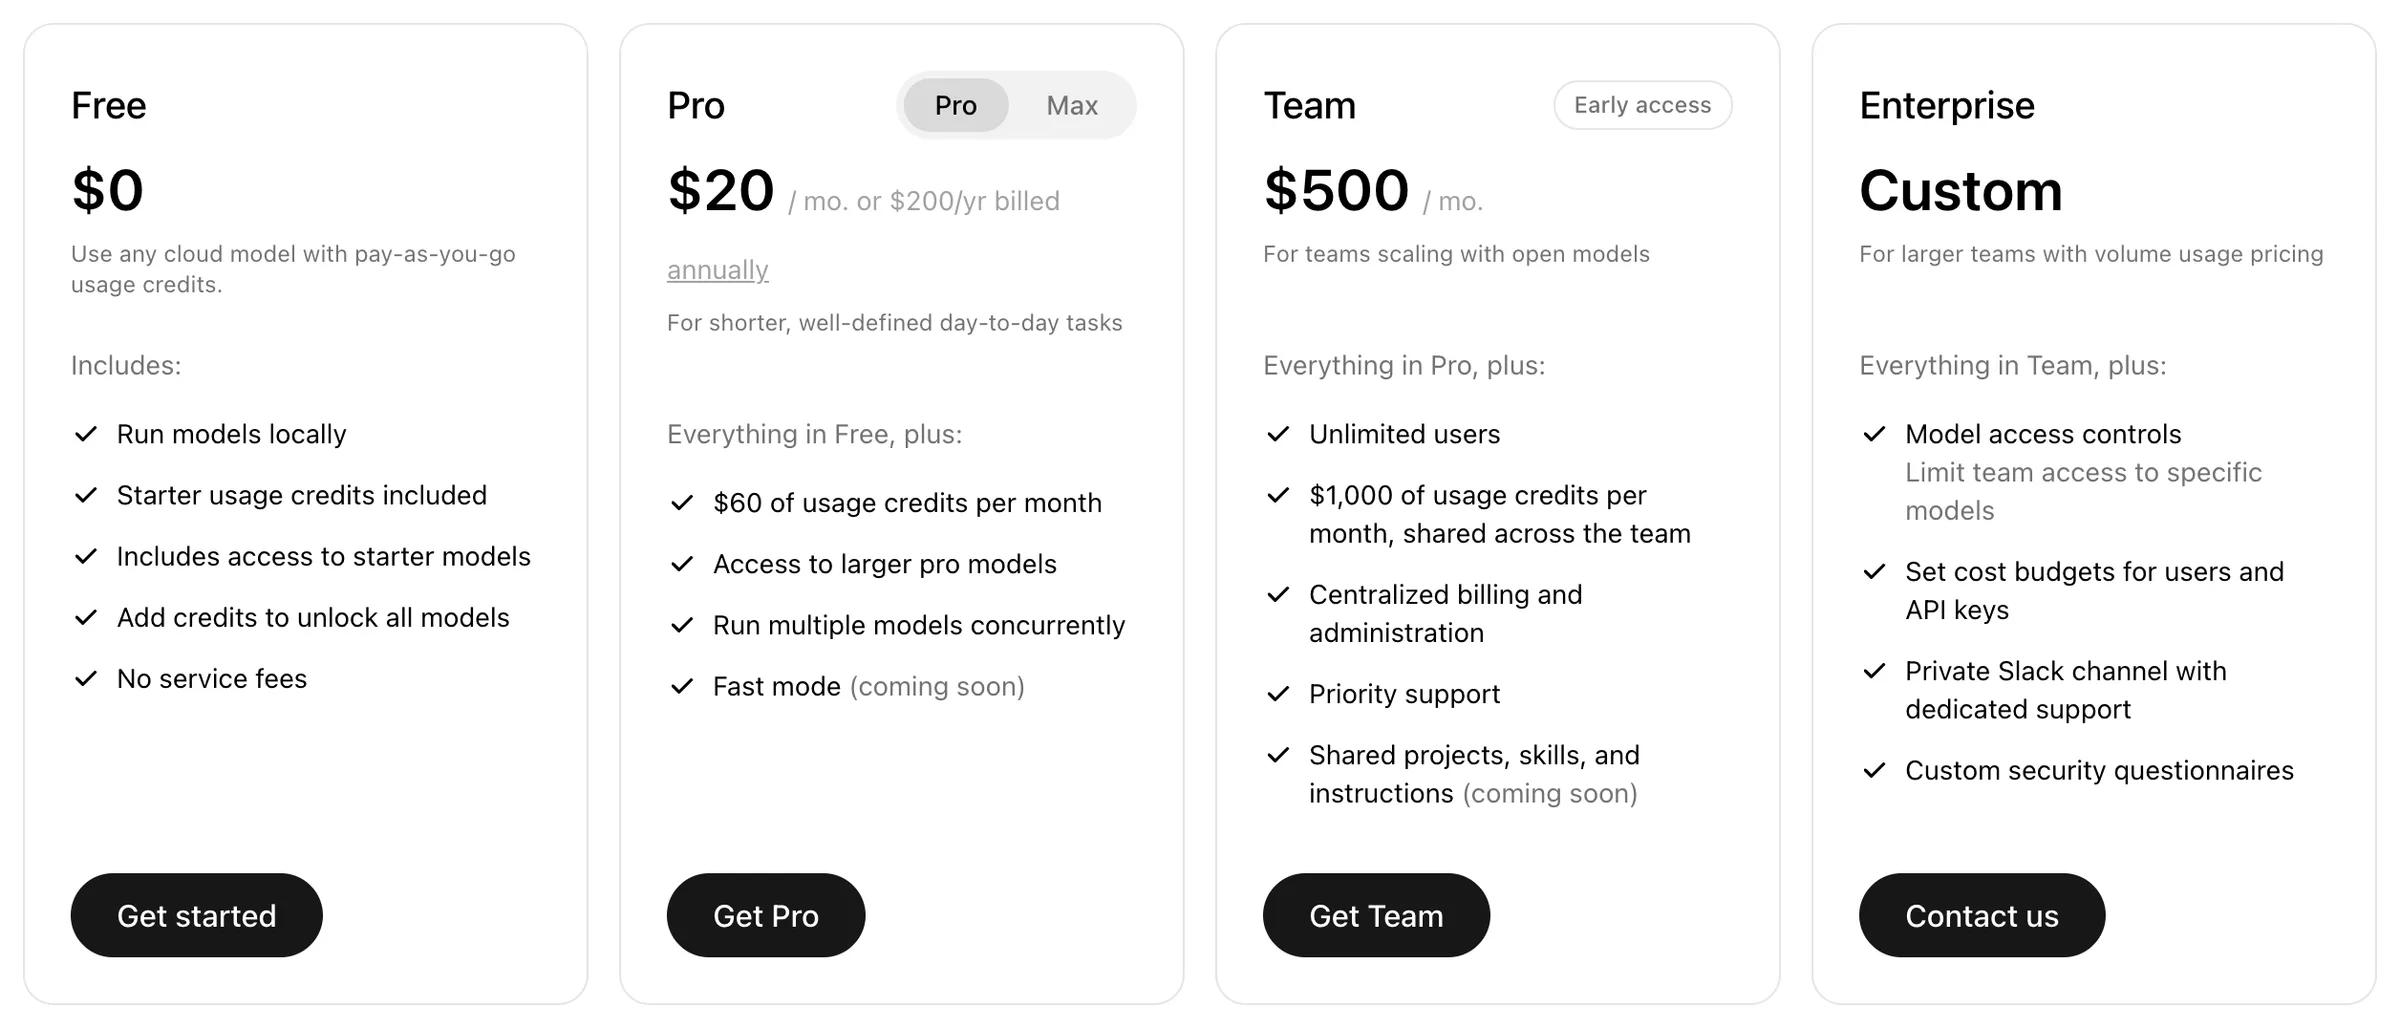
O plano gratuito traz créditos de uso iniciais, num valor que o Ollama não publica, para alguns modelos de entrada como o gemma4:cloud. O Pro custa US$ 20 por mês (US$ 200 por ano) com US$ 60 de uso por mês, e o Max, US$ 100 com US$ 300, segundo a página de preços do Ollama.
O Ollama diz que não armazena, não registra e não usa os prompts da nuvem para treinar modelos, e que hospeda principalmente nos Estados Unidos. Se os seus prompts levam dados pessoais de clientes, lembre que mandar esses dados para fora do Brasil é uma transferência internacional, que também precisa seguir a LGPD.
O que sai do seu computador
0 de 5 feitas
Problemas comuns do Claude Code com Ollama
A maioria dos erros de API do Claude Code com Ollama vem de quatro coisas: o Ollama desligado ou ocupado, um nome de modelo errado, contexto de menos ou memória de menos.
| O que você vê | O que significa | Solução |
|---|---|---|
| O Claude Code pede para você fazer login | Ele não recebeu nenhum token antes de abrir | Use ollama launch claude, ou defina ANTHROPIC_AUTH_TOKEN=ollama antes do claude |
| Um erro "Connection refused" ou "Unable to connect to API" | O Ollama não está rodando | Abra o app do Ollama (no Linux, ollama serve) e confira com ollama -v |
API Error: 404 ... model '...' not found | Modelo não baixado, nome errado, ou o Claude Code pediu um modelo do Claude | Rode ollama ls e faça ollama pull com o nome exato; no caminho manual, defina as quatro linhas de modelo |
A primeira resposta leva minutos, ou aparece API error · Retrying in 0s | O modelo está lendo o longo pedido de abertura do Claude Code, ou o Ollama ainda está ocupado com um pedido anterior | Espere: o Claude Code tenta de novo sozinho. Mantenha o Ollama atualizado (a versão 0.33.1 e as mais novas retomam um início interrompido) |
Ele esquece o seu pedido, para antes da hora ou diz no user query found in messages | O contexto é pequeno demais, então o Ollama cortou o começo da conversa | Ajuste para 64K, confira com ollama ps e digite /clear |
model requires more system memory ... than is available, ou uma divisão CPU/GPU no ollama ps | O modelo mais o contexto não cabem na memória de vídeo | Escolha um modelo menor ou um na nuvem, e feche outros apps |
| "Invalid tool parameters" ou "Error editing file" várias vezes | O modelo escreve chamadas de ferramenta quebradas | Use um modelo recomendado com 64K e atualize o Ollama |
403 ... this model requires a subscription | Esse modelo na nuvem não está no plano gratuito | Use o gemma4:cloud, compre créditos ou faça upgrade |
As linhas de login e de conexão seguem a documentação de solução de problemas de gateways da Anthropic; para o resto, o log do Ollama no Mac fica em ~/.ollama/logs/server.log.
Outras formas de rodar o Claude Code com modelo local
LM Studio
A versão 0.4.1 trouxe o mesmo endpoint no estilo da Anthropic. Inicie o servidor dele na porta 1234 e aponte a variável ANTHROPIC_BASE_URL para ele.
llama.cpp
O llama-server dele também fala o formato da Anthropic e conta os tokens com exatidão, mas você baixa os arquivos do modelo e roda tudo por conta própria.
OpenRouter
Nuvem, não local: os modelos gratuitos param em 50 pedidos por dia, e o OpenRouter só garante o Claude Code com os modelos da própria Anthropic.
Claude Desktop no Mac
O menu Apps do app do Ollama pode conectar o Claude Desktop aos modelos do Ollama, e desconectar devolve a sua configuração.
Os detalhes vêm da documentação do LM Studio e do OpenRouter. Para um agente feito para funcionar com qualquer modelo, leia Claude Code vs OpenCode.
Teste rápido0 de 3 corretas
Você configurou o Claude Code com Ollama e ele vive esquecendo o seu pedido. O que você confere primeiro?
Não exatamente.
A maioria dos computadores começa o Ollama com 4K ou 32K tokens, e só o pedido de abertura do Claude Code deu cerca de 20.000 tokens nos nossos testes, então uma janela pequena enche rápido e o Ollama corta o começo da conversa.
Depois de usar o ollama launch claude, você digita só claude numa janela nova. Qual modelo responde?
Não exatamente.
O launcher define as variáveis só para a sessão que ele abre e não muda nenhuma configuração do Claude Code.
Quem dá suporte ao Claude Code com modelos que não são do Claude?
Não exatamente.
A documentação da Anthropic diz que ela não dá suporte a direcionar o Claude Code para modelos que não são do Claude; o Ollama documenta e mantém a integração.
O que fazer agora
Instale o Ollama, ajuste o contexto para 64K e dê ao qwen3.8:27b (ou ao qwen3.5:4b, num computador menor) a nossa tarefa pequena numa cópia de uma pasta real. Cronometre e confira o resultado você mesmo antes de confiar mais trabalho a ele. Se a diferença para o Claude for grande demais para o seu trabalho, compare os planos no nosso guia de preços do Claude Code e, se você quer um caminho guiado por projetos reais, o curso de Claude Code está aberto em acesso antecipado.
Kit de teste de modelos locais para o Claude Code
Um seletor de modelo por memória, três tarefas cronometradas com checklist, todas as configurações numa tabela e como voltar atrás ou remover o Ollama.
Digite seu e-mail e a seção completa abre aqui mesmo. Você também ganha uma aula grátis do curso.
Perguntas frequentes
Preciso de uma conta do Claude para usar o Claude Code com Ollama?
Não. Quando a variável ANTHROPIC_AUTH_TOKEN está definida antes de o Claude Code abrir, o que o ollama launch claude faz por você, o Claude Code pula o login do Claude e manda todos os pedidos para o Ollama. Recursos que exigem login no claude.ai, como Remote Control, sessões na nuvem e ditado por voz, não ficam disponíveis nessa sessão.
O Claude Code funciona offline com o Ollama?
Com um modelo local, sim: depois que o Ollama e o modelo estão no seu computador, o modelo não precisa de internet. O Claude Code ainda tenta falar com a Anthropic para buscar atualizações e enviar métricas de uso, a menos que você defina CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, e pesquisar na web ou abrir uma página exige conexão.
Como faço o Claude Code voltar para os modelos do Claude?
Rode só claude numa janela nova do terminal. O ollama launch claude define as variáveis apenas para a sessão que ele abre, então o seu plano do Claude continua intacto; se você mesmo exportou as variáveis, feche aquela janela ou tire as variáveis do perfil do seu shell.
Dá para usar o Claude Code com Ollama no VS Code?
Sim. Coloque as mesmas variáveis (ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN e os nomes dos modelos) em claudeCode.environmentVariables, nas configurações de usuário do VS Code, e reinicie o painel do Claude Code. A extensão do próprio Ollama para o VS Code é outra coisa: ela coloca os modelos do Ollama no chat embutido do VS Code.
Dá para usar modelos do Ollama no app de desktop do Claude?
No Mac, sim: abra o app do Ollama, escolha Apps e conecte o Claude, e o Ollama configura o Claude Desktop para usar os modelos dele; desconectar devolve a sua configuração normal. Para o Windows, o Ollama diz que o suporte vem em breve.
Continue lendo
Claude Code vs OpenCode (2026): custo, modelos e privacidade
Claude Code vs OpenCode, conferido em outubro de 2026: benchmarks, custos reais, por que o Claude Pro não funciona no OpenCode, modelos locais e privacidade.
Claude Code · 14 min de leituraClaude Code: preço e planos 2026 (Pro vs Max, Team e API)
Quanto custa o Claude Code em 2026: preço e planos conferidos na Anthropic, se há versão grátis, Pro vs Max, Team, Enterprise, API por token e qual escolher.
Claude Code · 17 min de leituraComo instalar o Claude Code no Windows e no Mac (2026)
Como instalar o Claude Code no Windows ou Mac com o instalador oficial ou o app sem terminal, fazer login, rodar a primeira tarefa e corrigir os erros comuns.
Claude Code · 19 min de leitura