Claude Code con Ollama: modelos locales gratis (guía 2026)
Configura Claude Code con un modelo abierto y gratuito en Ollama en cuatro pasos, elige el que cabe en tu equipo y mira lo que medimos en una Mac de 48 GB en octubre de 2026.
Por Yotam DahanActualizado 20 min de lecturaClaude Code
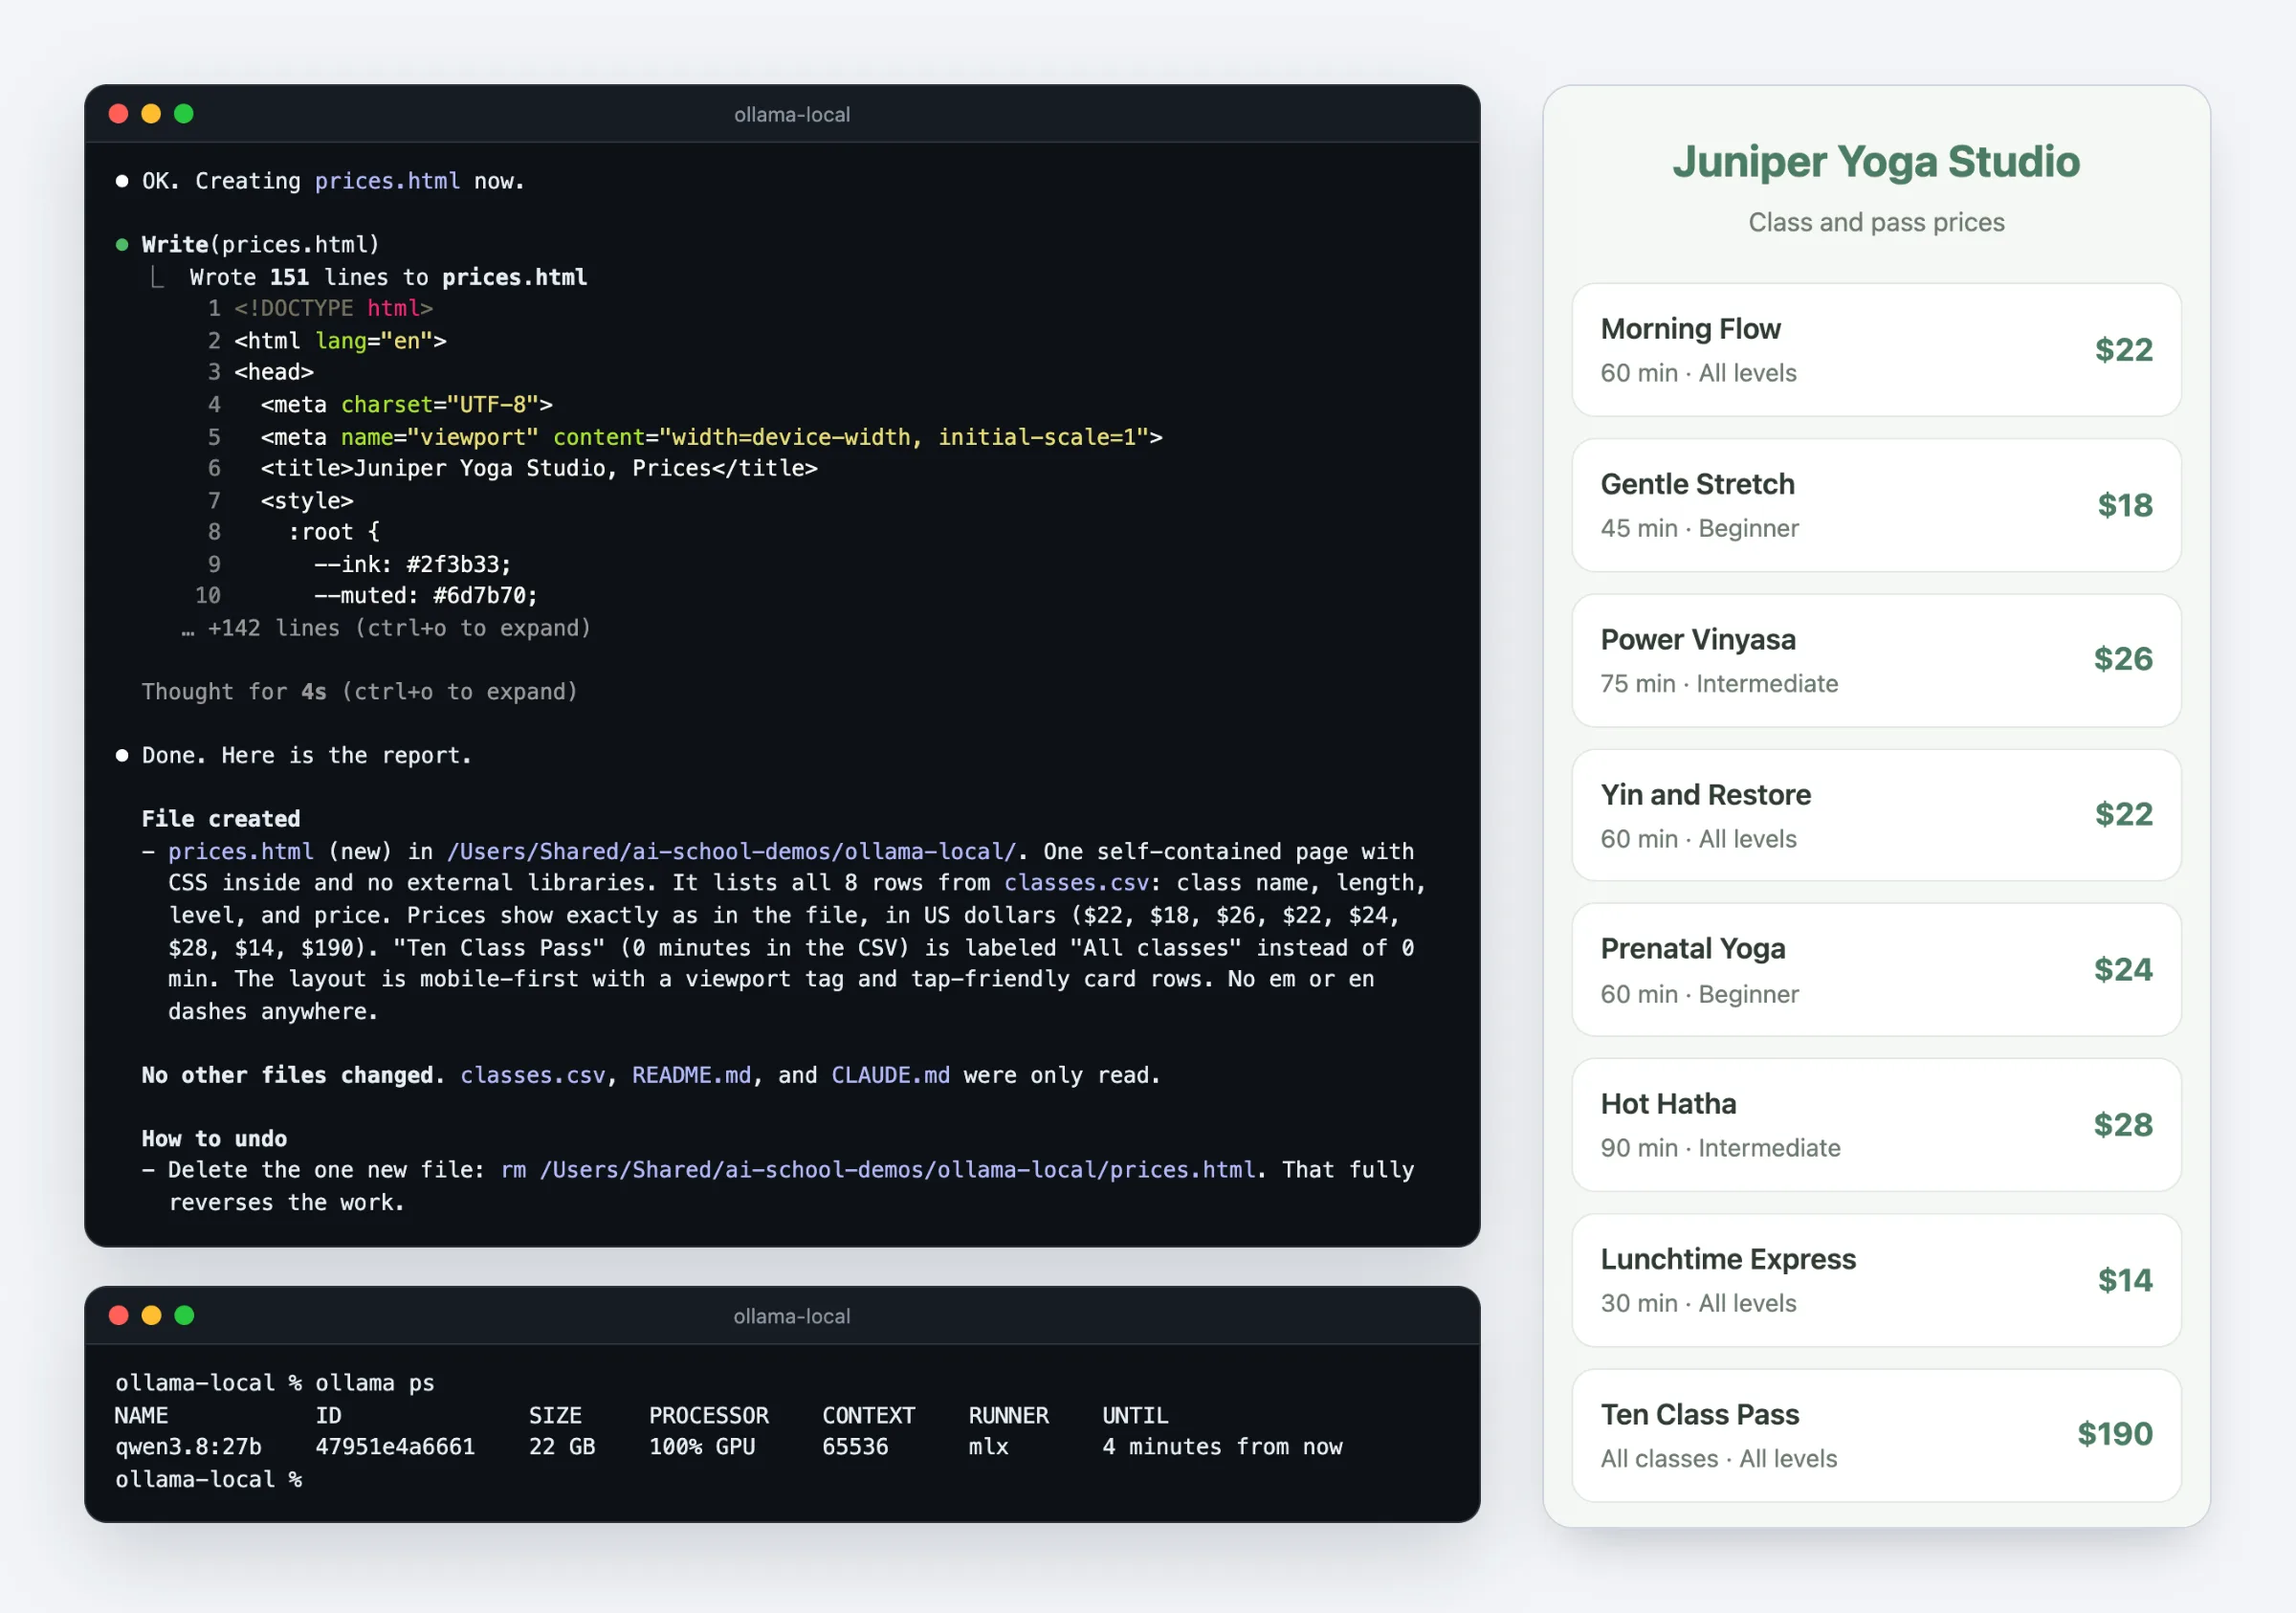
Claude Code con Ollama te permite usar Claude Code con un modelo abierto y gratuito en tu propia computadora en lugar de Claude: instalas Ollama, subes su longitud de contexto a 64K y ejecutas ollama launch claude. Funciona, pero es una configuración de Ollama, no de Anthropic: Anthropic no da soporte a Claude Code con modelos que no sean de Claude, y un modelo local es mucho más débil y lento que Claude. Úsalo para experimentos privados y trabajos simples, no como reemplazo directo de un plan de Claude.
Cómo funciona Claude Code con Ollama
Claude Code es el agente: el programa que lee tus archivos, ejecuta comandos y te pregunta antes de cambiar algo. El modelo es el cerebro que lo mueve, que normalmente es Claude, en los servidores de Anthropic.
Desde la versión 0.14.0, de enero de 2026 (según las notas de versión de Ollama), Ollama responde con el mismo formato de mensajes que la API de Anthropic, en tu propia computadora, en el puerto 11434. Si apuntas Claude Code ahí, funciona con un modelo abierto (uno que cualquiera puede descargar y ejecutar). Claude Code en sí no cambia, y sigue bajo los términos de Anthropic sea cual sea el modelo que tenga detrás.
Tú
Le pides un cambio a Claude Code en español, con tus palabras
Claude Code
Lee tus archivos y envía el pedido a Ollama en el puerto 11434
Ollama
Ejecuta el modelo abierto en el chip gráfico de tu computadora
Tus archivos
Claude Code aplica las ediciones que pide el modelo, con tu permiso
Qué necesitas
La memoria decide casi todo: el modelo tiene que caber en la memoria que puede usar tu chip gráfico, con espacio para la conversación, o irá lentísimo. Para usar Claude Code con Ollama gratis no necesitas un plan de Claude ni una API key, y puedes instalar Claude Code con Ollama en el mismo paso (o seguir nuestra guía para instalar Claude Code). Por dónde empezar si quieres Claude Code local con Ollama:
| Tu computadora | Empieza con | Descarga | Memoria que indica Ollama |
|---|---|---|---|
| 16 GB o menos | qwen3.5:4b | 3.3 a 4.0 GB | Unos 6 GB |
| 24 a 32 GB | gemma4:12b | 7.7 a 8.0 GB | Unos 11 GB |
| 48 GB o más | qwen3.8:27b | 18 GB | Unos 28 GB |
| Cualquier computadora, con una cuenta de ollama.com | gemma4:cloud | Nada | Corre en los servidores de Ollama |
Las cifras de memoria son las que muestra el lanzador de Ollama y las descargas salen de la biblioteca de Ollama; revisamos ambas el 22 de octubre de 2026. Si usas PC, compara esa cifra con la memoria de tu tarjeta gráfica. La app para Mac pesa unos 214 MB.
Paso 1: instala Ollama en Mac, Windows o Linux
Configurar Claude Code con Ollama empieza por el instalador de ollama.com/download: una app que mantiene un pequeño servidor en segundo plano, más el comando ollama.
- Mac (macOS 14 o posterior): descarga Ollama.dmg, arrastra Ollama a Aplicaciones y ábrelo; te ofrece agregar el comando
ollamaa tu terminal. - Windows 10 (22H2) u 11: ejecuta OllamaSetup.exe, que no necesita permisos de administrador.
- Linux: ejecuta el script de instalación de abajo; deja Ollama configurado como servicio en segundo plano.
- Compruébalo: abre una ventana nueva de la terminal y ejecuta
ollama -v.
Los instaladores oficiales de una línea, para Mac o Linux:
curl -fsSL https://ollama.com/install.sh | sh
En Windows, en PowerShell:
irm https://ollama.com/install.ps1 | iex
ollama -v
ollama version is 0.40.8
En Windows, las tarjetas NVIDIA necesitan el driver 551.61 o más reciente, y las AMD Radeon funcionan con ROCm o Vulkan, según la documentación de Ollama para Windows.
Paso 2: sube la longitud de contexto a 64K
La longitud de contexto es cuánto de la conversación puede ver el modelo a la vez, medida en tokens (pequeños trozos de texto). Solo la solicitud inicial de Claude Code, sus instrucciones más la descripción de cada herramienta, ocupó unos 20,300 tokens en nuestras pruebas sin plugins, y hay usuarios que reportan hasta 36,000. Por eso Ollama pide 64K.
Ollama elige un valor por defecto según tu memoria gráfica, y la mayoría de las computadoras quedan por debajo de esa cifra. En Mac cuenta la parte de la memoria que puede usar el chip gráfico, y el registro de nuestro MacBook Pro de 48 GB muestra el resultado: vram-based default context total_vram="37.4 GiB" default_num_ctx=32768, es decir, 32K.
por defecto con menos de 24 GB de memoria gráfica
por defecto entre 24 y 48 GB, incluida nuestra Mac de 48 GB
por defecto con 48 GB o más
lo que Ollama pide para Claude Code
Niveles de la documentación sobre la longitud de contexto de Ollama, revisada el 22 de octubre de 2026. Los 32K de nuestra Mac salen de su propio registro de Ollama.
Puedes subir la longitud de contexto de cuatro formas, todas del lado de Ollama:
- La app de Ollama (Mac y Windows): abre Settings (configuración) y pon Context length (longitud de contexto) en 64k, que la app guarda como 65,536 tokens.
- Una terminal, con la app cerrada: ejecuta
OLLAMA_CONTEXT_LENGTH=65536 ollama servey deja la ventana abierta (lo que hicimos nosotros). - Un servicio de Linux: ejecuta
sudo systemctl edit ollama, agrega las dos líneas de abajo y luego reinicia el servicio. - Un solo modelo, en cualquier sistema: guarda una copia del modelo con una ventana más grande y usa su nombre nuevo (aquí
qwen3.8-64k) en lugar deqwen3.8:27b.
[Service]
Environment="OLLAMA_CONTEXT_LENGTH=65536"sudo systemctl daemon-reload && sudo systemctl restart ollama
Para la copia, pon estas dos líneas en un archivo de texto plano llamado Modelfile (sirve el Bloc de notas) y luego crea el modelo desde esa carpeta:
FROM qwen3.8:27b
PARAMETER num_ctx 65536ollama create qwen3.8-64k -f Modelfile
Después carga un modelo y comprueba lo que Ollama le dio en realidad:
ollama ps
NAME ID SIZE PROCESSOR CONTEXT RUNNER UNTIL
qwen3.8:27b 47951e4a6661 22 GB 100% GPU 65536 mlx 4 minutes from now
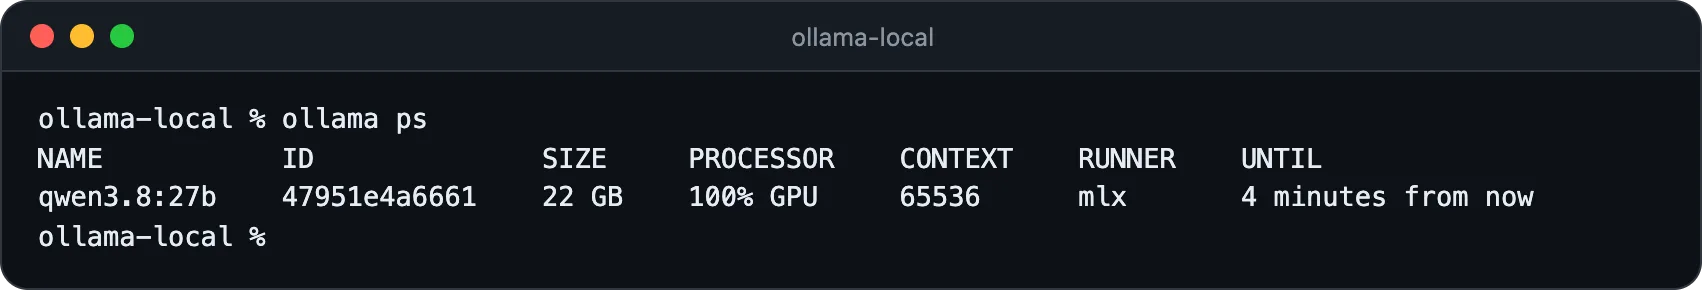
CONTEXT debe ser 64K o más y PROCESSOR, 100% GPU; una división como 48%/52% CPU/GPU significa que parte del modelo pasó a una memoria más lenta. En Mac, RUNNER mlx significa el motor MLX de Apple.
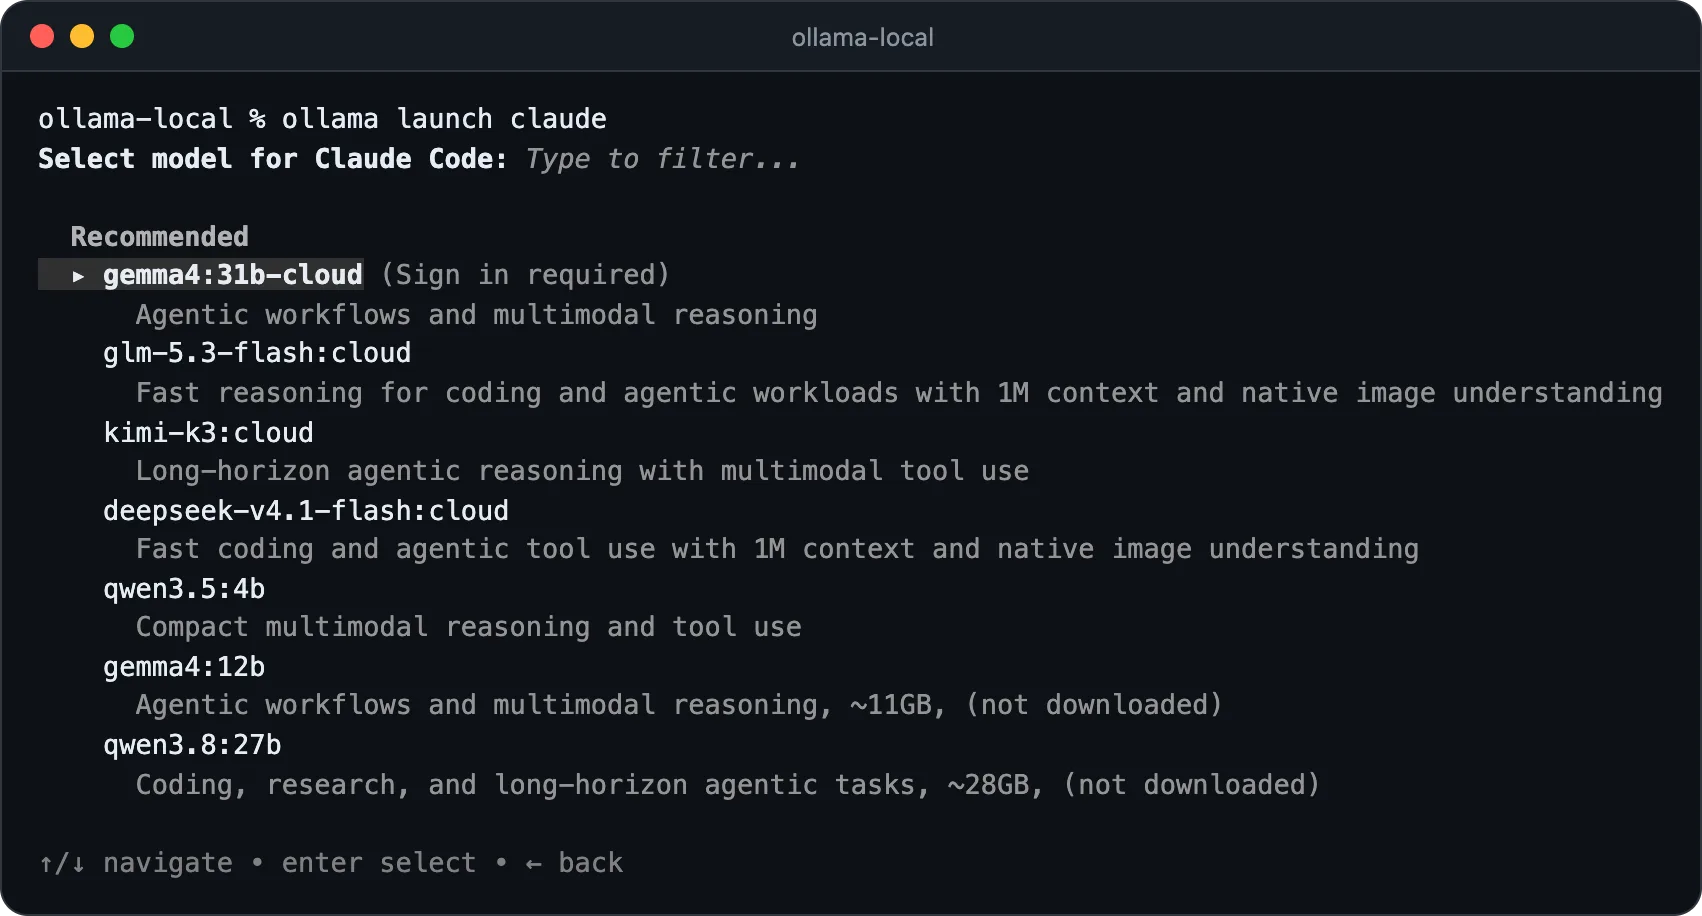
Paso 3: inicia Claude Code con ollama launch claude
Abre una terminal en la carpeta en la que quieres que trabaje Claude Code (Terminal en Mac, PowerShell en Windows) y ejecuta:
ollama launch claude
- Elige un modelo. Bajo "Recommended" (recomendados), la lista muestra primero los modelos en la nube de Ollama (piden iniciar sesión en ollama.com) y después los locales con la memoria que necesitan, marcados como "not downloaded" (sin descargar) hasta que los tengas.
- Deja que se descargue. Si el modelo todavía no está en tu computadora, Ollama lo descarga primero. Los 18 GB de qwen3.8:27b tardaron 6 minutos y 43 segundos con nuestra conexión.
- Instala Claude Code si te lo pide. Si falta, Ollama pregunta "Claude Code is not installed. Install now?" (Claude Code no está instalado, ¿instalarlo ahora?) y ejecuta el instalador oficial de Anthropic.
- Confía en la carpeta. Un Claude Code recién instalado te pide un tema y si confías en la carpeta, sin pantalla de inicio de sesión. Después, la cabecera muestra el modelo que responde:
qwen3.8:27b · API Usage Billing.
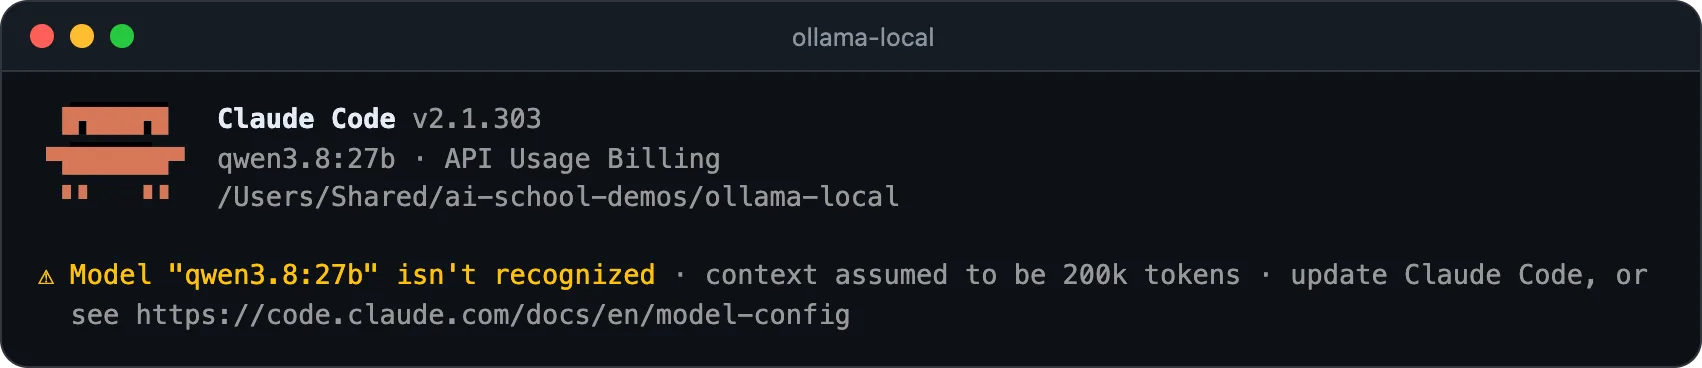
Esa línea amarilla importa. Claude Code conoce el tamaño de contexto de los modelos de Claude, no el de qwen3.8:27b, así que mostró Model "qwen3.8:27b" isn't recognized · context assumed to be 200k tokens (el modelo no se reconoce, se asume un contexto de 200k tokens), como describe la documentación de configuración de modelos de Anthropic, y esperaría demasiado para compactar (resumir) una conversación larga. Ábrelo con un tamaño un poco menor que el de Ollama y el aviso desaparece:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000 ollama launch claude --model qwen3.8:27b
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
ollama launch claude --model qwen3.8:27b
Para esa sesión, el lanzador apunta Claude Code a Ollama con un token ficticio, así que no hace falta iniciar sesión en Claude, y asigna tu modelo a cada nivel de modelo, incluidos los agentes de apoyo. No escribe ninguna configuración de Claude Code: claude a secas en una ventana nueva vuelve a tu plan de Claude. --yes (junto con --model) se salta todas las preguntas, y todo lo que va después de -- pasa a Claude Code, como en ollama launch claude --model qwen3.8:27b -- --resume.
La vía manual: variables de entorno
Para abrir claude a secas, define las variables tú mismo. La documentación de Claude Code de Ollama lista las tres primeras; las líneas de modelo son las que agrega el lanzador, porque sin ellas algunos ayudantes de Claude Code le piden a Ollama un modelo de Claude y reciben "model not found" (modelo no encontrado). En Mac o Linux:
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3.8:27b
export CLAUDE_CODE_SUBAGENT_MODEL=qwen3.8:27b
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000
claude --model qwen3.8:27b
En Windows, en PowerShell:
$env:ANTHROPIC_BASE_URL = "http://localhost:11434"
$env:ANTHROPIC_AUTH_TOKEN = "ollama"
Remove-Item Env:ANTHROPIC_API_KEY -ErrorAction SilentlyContinue
$env:ANTHROPIC_DEFAULT_OPUS_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_SONNET_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_HAIKU_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_SUBAGENT_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
claude --model qwen3.8:27b
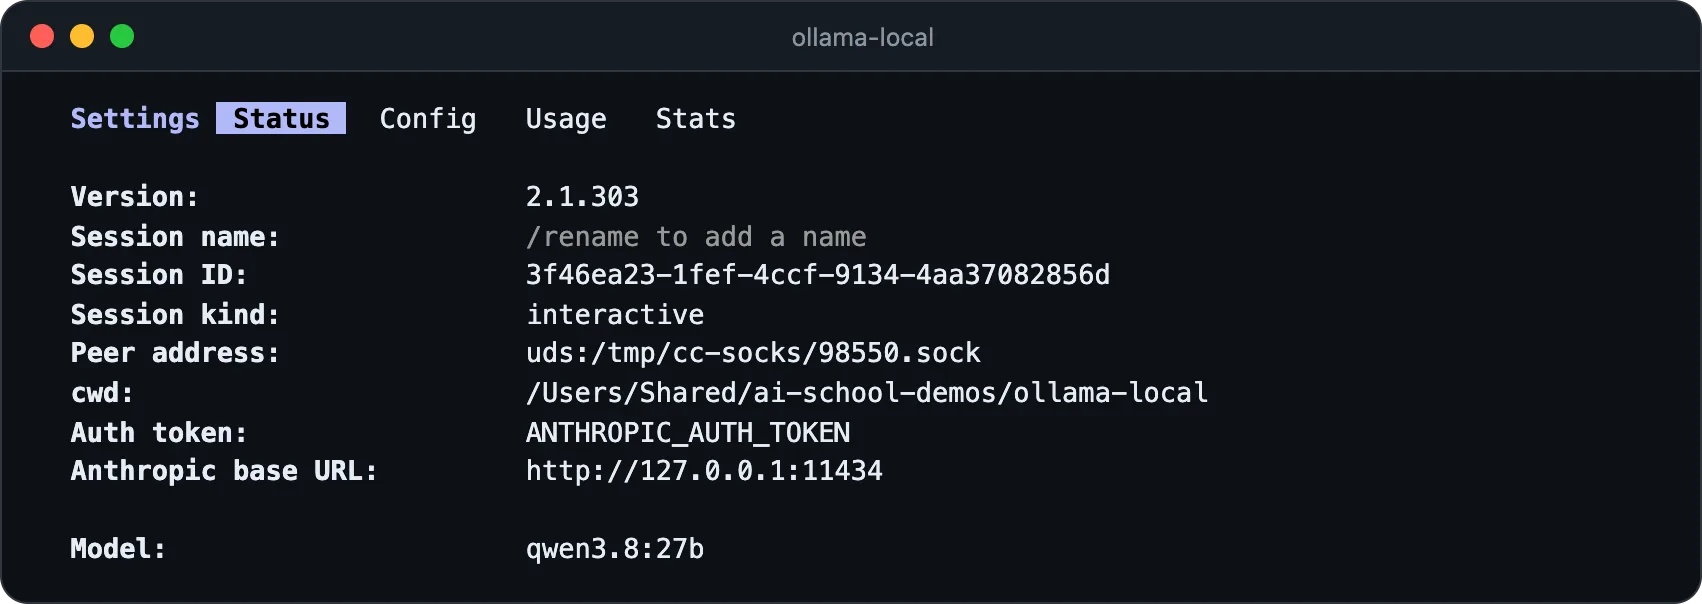
PowerShell no puede guardar una variable vacía, así que la versión de Windows elimina ANTHROPIC_API_KEY, con el mismo efecto. Los ajustes duran hasta que cierras la ventana. Para confirmar cualquiera de las dos vías, escribe /status: la línea del token de autenticación debe nombrar ANTHROPIC_AUTH_TOKEN, y la URL base, tu propia computadora en el puerto 11434.
Los mejores modelos de Ollama para Claude Code
El mejor modelo de Ollama para Claude Code depende de tu memoria, y los modelos que recomienda el lanzador cambian con el tiempo. El 22 de octubre de 2026, las opciones locales eran las tres de la tabla de arriba: todas pueden llamar herramientas, algo de lo que depende Claude Code (leer un archivo, editarlo, ejecutar un comando), todas llegan a un contexto máximo de 256K y todas usan la licencia Apache 2.0. Las opciones en la nube:
| Modelo en la nube | Contexto | Plan |
|---|---|---|
gemma4:cloud | 256K | Créditos iniciales del plan Free |
glm-5.3-flash:cloud | 1M | Pro o créditos comprados |
kimi-k3:cloud | 1M | Pro o créditos comprados |
deepseek-v4.1-flash:cloud | 1M | Pro o créditos comprados |
Ahora, la parte honesta. Terminal-Bench 4.0 es un conjunto de tareas reales de terminal que Artificial Analysis ejecuta de la misma forma con cada modelo:
De Artificial Analysis, revisado el 22 de octubre de 2026. Son los modelos completos, alojados en servidores; no esperes que las versiones comprimidas que descargas en un portátil lo hagan mejor. Gemma 4 no tiene puntuación en esta prueba.
GLM-5.3-Flash y DeepSeek V4.1 Flash, los dos en la nube de Ollama, sacan unas seis veces lo que saca Qwen3.8 27B, y Claude sigue muy por delante de todos. Nuestro ranking de modelos de IA muestra el panorama completo.
Lo que vimos en una Mac de 48 GB
Para ver la diferencia en un trabajo pequeño y real, les di a los dos modelos locales la lista de clases de un estudio de yoga de demostración y el prompt de prueba de nuestra guía de agentes de IA para programar, que puedes usar con tus propios archivos:
Trabaja solo dentro de esta carpeta. Lee [ARCHIVO CON TUS PRECIOS O SERVICIOS] y crea una lista de precios de una sola página llamada precios.html que se vea bien en el teléfono. Antes de cambiar nada, dime tu plan en tres viñetas y espera mi visto bueno. Cuando termines, enumera cada archivo que creaste o cambiaste y cómo puedo deshacerlo.| Modelo y contexto | Primera respuesta tras | Tarea completa | ¿Funcionó la página? | Errores de herramientas |
|---|---|---|---|---|
| qwen3.8:27b, 64K | 3 min 27 s | 5 min 30 s | Sí | 0 |
| qwen3.5:4b, 64K | 43 s | 1 min 39 s | En parte | 0 |
| qwen3.5:4b, 32K por defecto, primera ejecución | 7 min 10 s, tras un error de API | 8 min 7 s | En parte | 0, más 1 reintento automático |
tokens por segundo al escribir, qwen3.8:27b
tokens por segundo al escribir, qwen3.5:4b
tokens por segundo al leer, qwen3.8:27b, aproximadamente
de memoria usada por qwen3.8:27b después de la tarea
Nuestras mediciones en un MacBook Pro con M4 Pro y 48 GB, Ollama 0.40.8, 22 de octubre de 2026. Las velocidades de escritura son ejecuciones en caliente de ollama run --verbose; la de lectura sale del registro de Ollama para la solicitud inicial de Claude Code. Los tiempos cuentan el trabajo del modelo, no lo que tardamos en escribir.
qwen3.8:27b lo hizo bien: una página limpia, los ocho precios exactos, un plan preciso y ningún error de herramientas. Su primera respuesta tardó 3 minutos y 27 segundos porque leyó la solicitud inicial de 20,300 tokens de Claude Code a unos 117 tokens por segundo; después, la caché de Ollama hizo que cada paso fuera rápido.
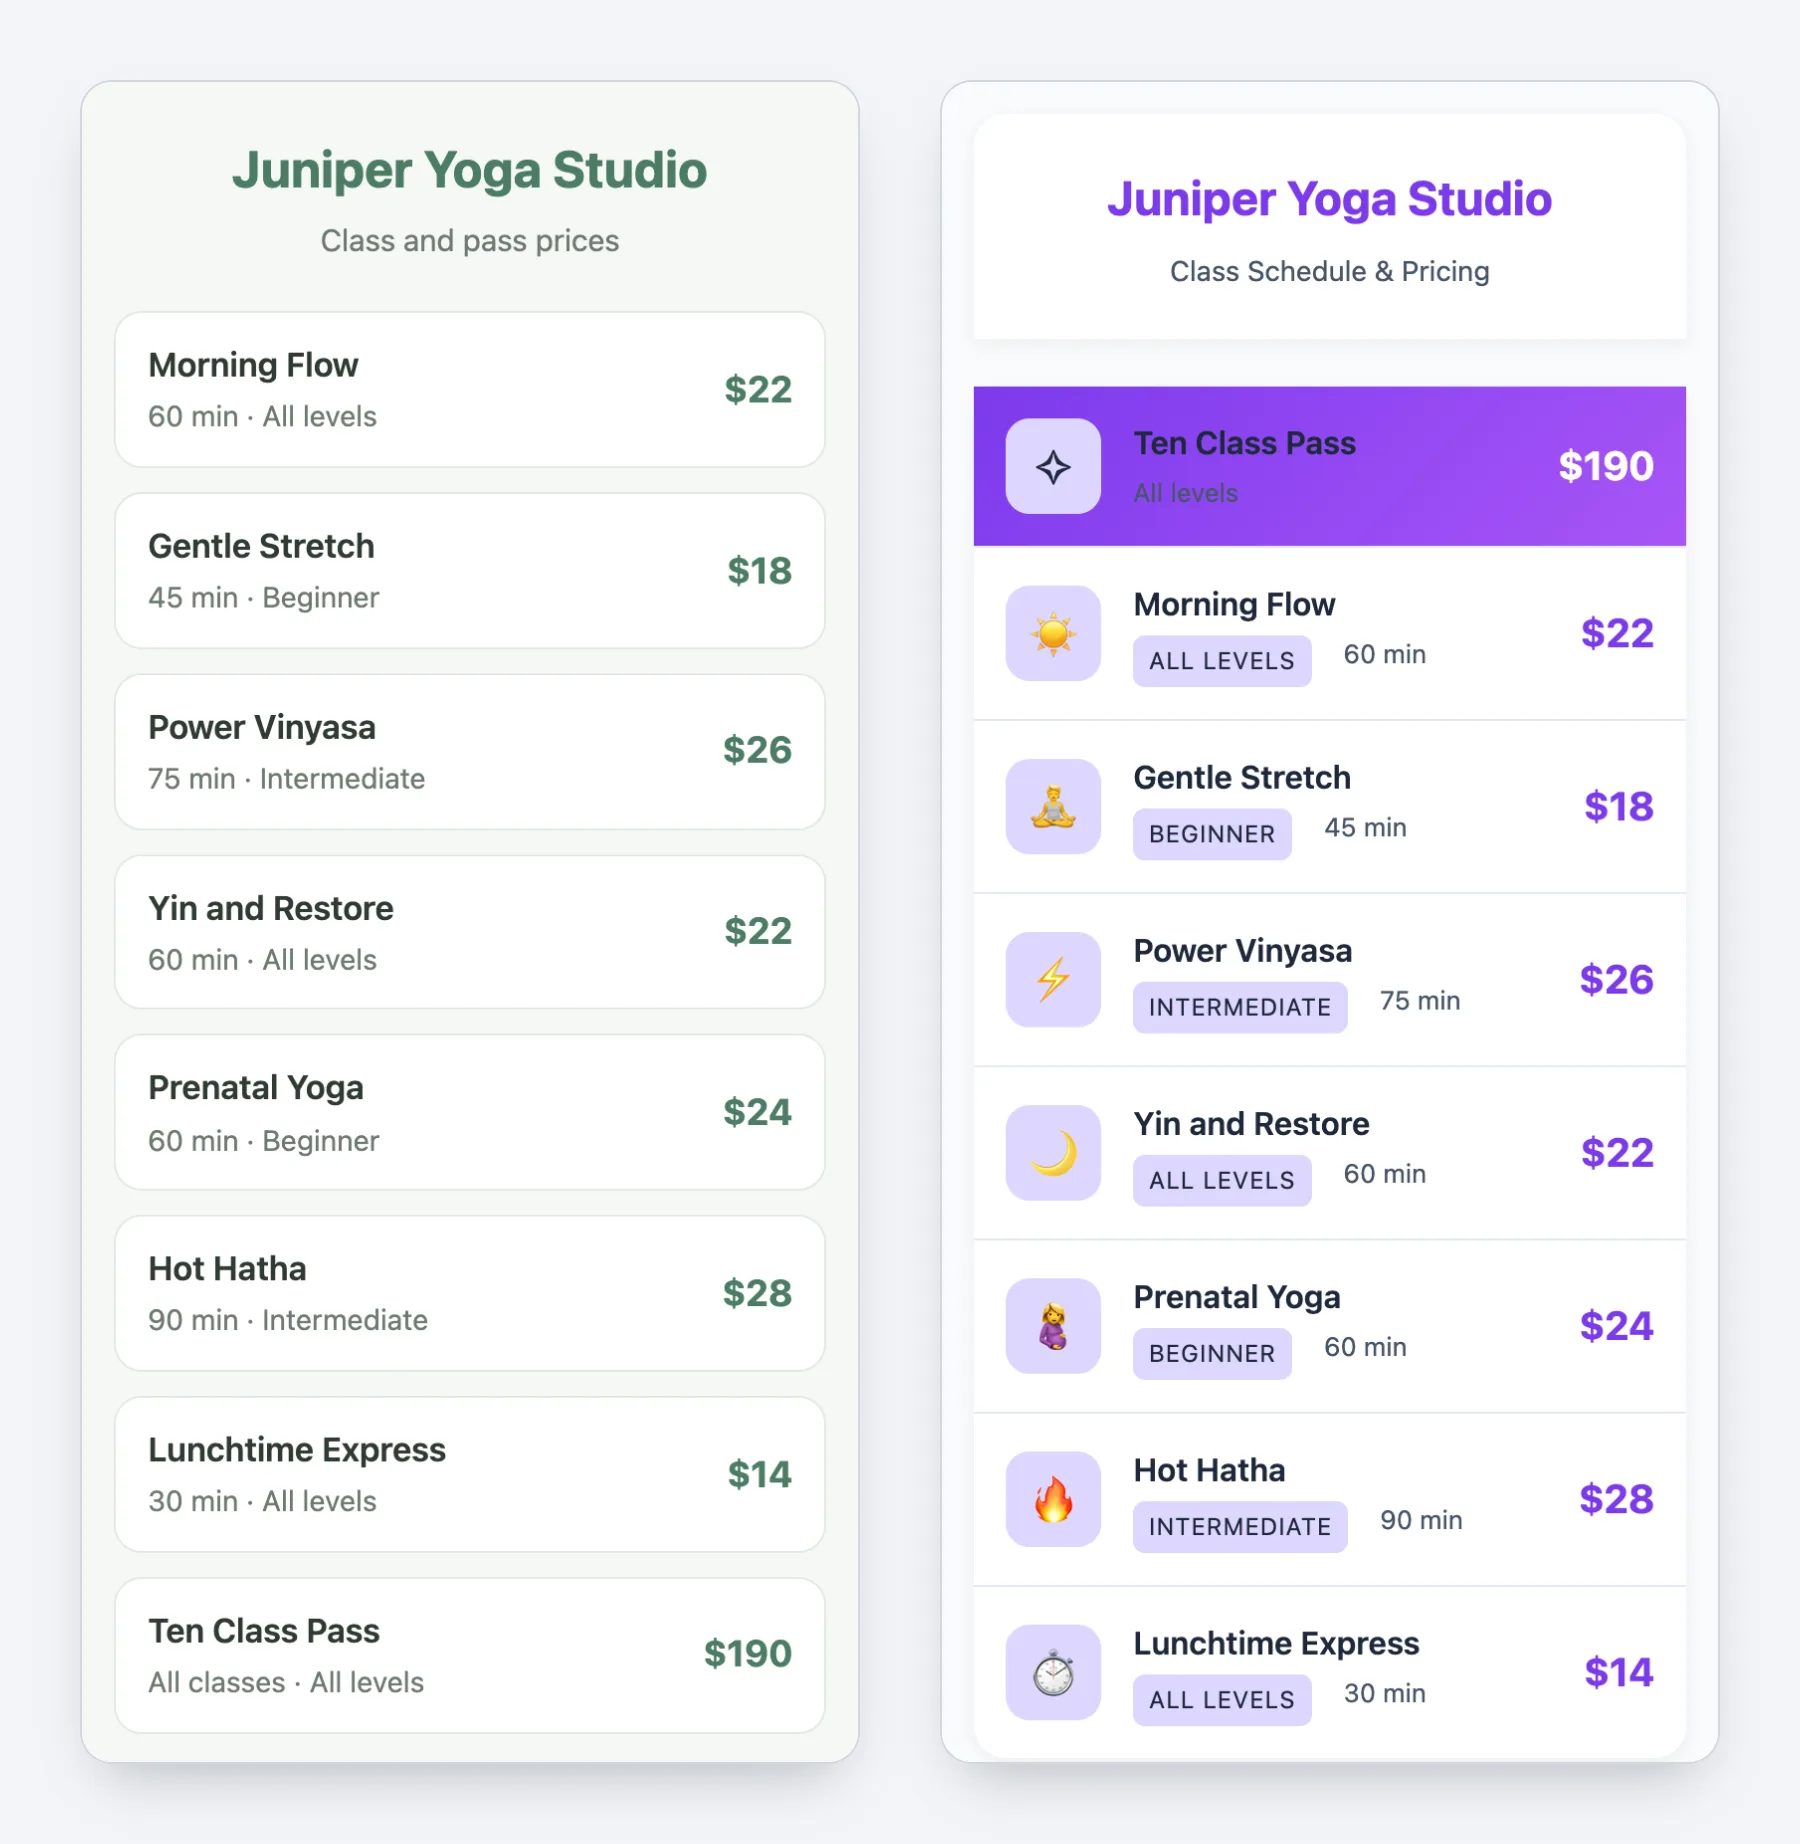
qwen3.5:4b leyó la misma solicitud en unos 28 segundos y terminó en menos de dos minutos, pero es una demo rápida, no un trabajador confiable: precios correctos, una fila difícil de leer y un guion largo (em dash) en su respuesta, que el CLAUDE.md de la carpeta prohíbe. En su primera ejecución, con los 32K por defecto, su plan puso una clase a $29 (el archivo dice $28), después de esto:
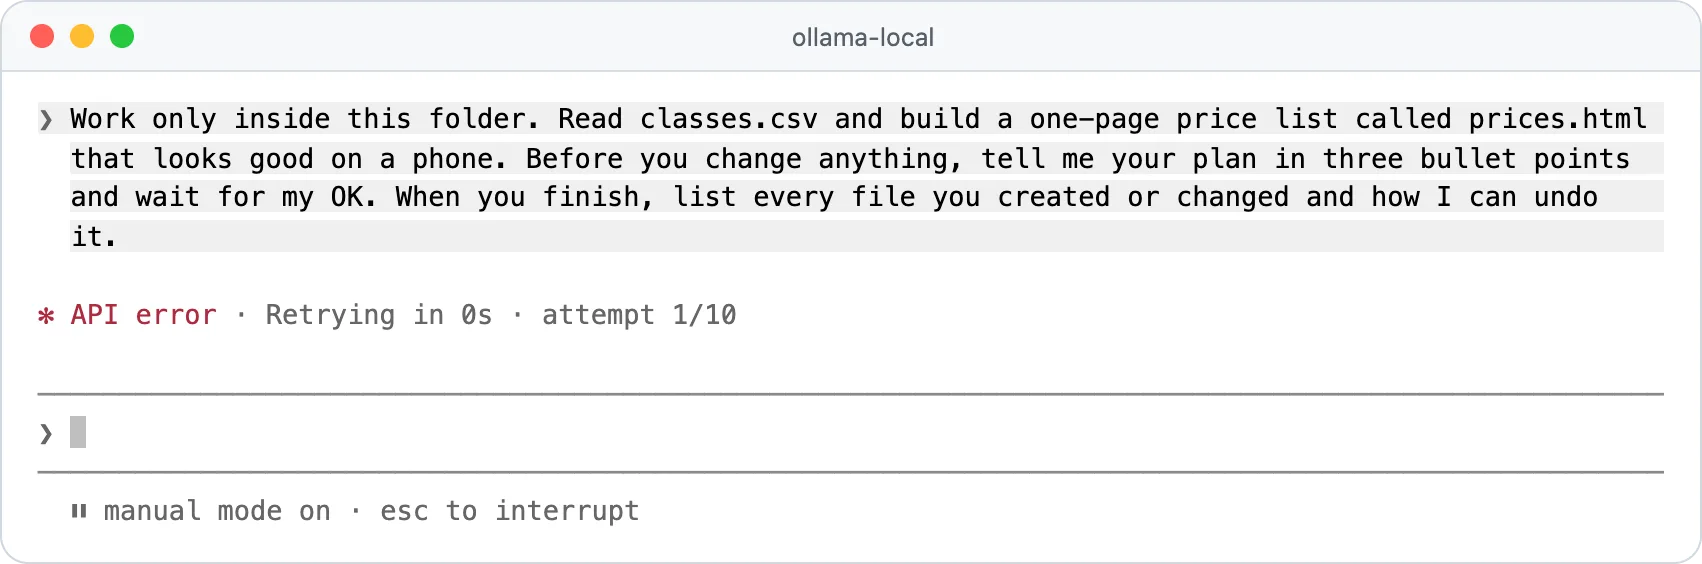
Ollama envió un error HTTP 500 a los 5 minutos y 22 segundos, mientras el modelo seguía ocupado con una pequeña solicitud secundaria; Claude Code mostró API error · Retrying in 0s · attempt 1/10 (error de API, reintento en 0 s, intento 1 de 10) y volvió a intentarlo solo. No arreglamos nada a mano en ninguna ejecución.
Qué deja de funcionar sin Claude
El agente es el mismo programa, así que casi todo Claude Code sigue funcionando. Lo que depende de los servidores de Anthropic o de una sesión de Claude cambia:
Funciona
Leer y editar archivos, ejecutar comandos con tu permiso, los planes que apruebas y los agentes de apoyo, que Ollama admite.
Cambia
La búsqueda web propia de Claude queda desactivada. Con los modelos en la nube de Ollama, la búsqueda web de Ollama ocupa su lugar, y necesita una cuenta de ollama.com.
Desaparece
Remote Control, el dictado por voz, las sesiones en la nube y la pestaña Code de la app de escritorio, porque todos necesitan iniciar sesión en Claude.
Más tosco
Sin la caché de prompts de Anthropic, conteos de tokens estimados en /context, sin lectura de PDF y con un modelo que puede ignorar las reglas de tu CLAUDE.md.
Fuentes: la página de disponibilidad de funciones de Anthropic y la lista de compatibilidad con Anthropic de Ollama.
Modelos en la nube de Ollama para Claude Code
Los modelos que terminan en :cloud corren en los servidores de Ollama: sin descarga, sin necesidad de un chip gráfico potente y con puntuaciones mucho más altas. A cambio, necesitan una cuenta de ollama.com (ollama signin), y tus prompts salen de tu computadora.
ollama launch claude --model gemma4:cloud
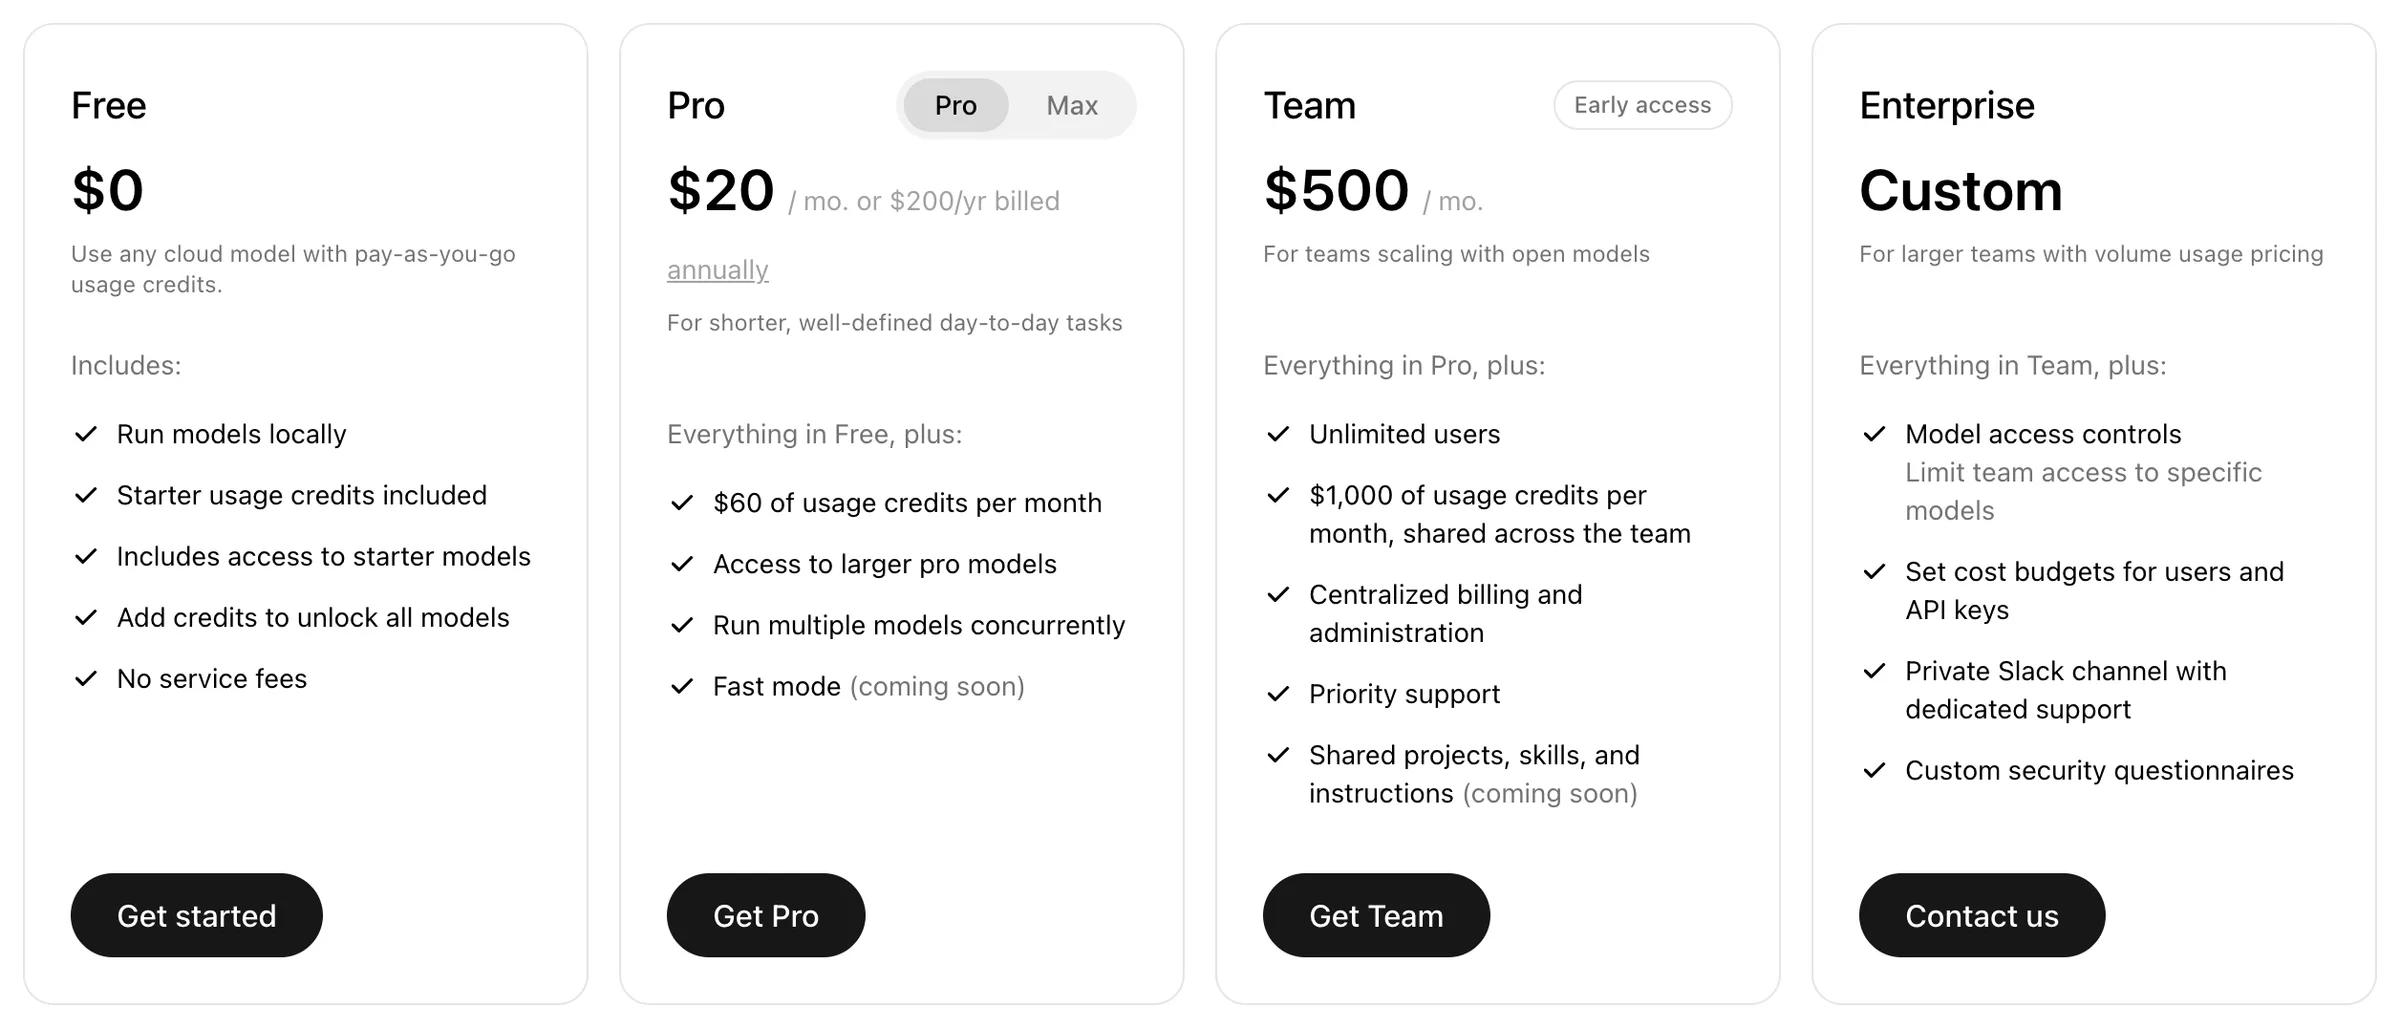
El plan gratis incluye créditos de uso iniciales, en una cantidad que Ollama no publica, para algunos modelos de inicio como gemma4:cloud. Pro cuesta $20 al mes ($200 al año) con $60 de uso al mes, y Max, $100 con $300, en dólares estadounidenses, según los precios de Ollama. Ollama dice que no guarda, registra ni entrena con los prompts de la nube, y que aloja sobre todo en Estados Unidos.
Qué sale de tu computadora
0 de 5 hechas
Problemas comunes de Claude Code con Ollama y cómo resolverlos
La mayoría de los errores de API de Claude Code con Ollama se reducen a cuatro causas: Ollama está apagado u ocupado, el nombre del modelo está mal, falta contexto o falta memoria.
| Lo que ves | Qué significa | Solución |
|---|---|---|
| Claude Code te pide iniciar sesión | No recibió ningún token antes de arrancar | Usa ollama launch claude, o define ANTHROPIC_AUTH_TOKEN=ollama antes de claude |
| Un error "Connection refused" o "Unable to connect to API" | Ollama no está corriendo | Abre la app de Ollama (en Linux, ollama serve) y luego comprueba con ollama -v |
API Error: 404 ... model '...' not found | El modelo no está descargado, el nombre está mal o Claude Code pidió un modelo de Claude | Ejecuta ollama ls y haz ollama pull con el nombre exacto; en la vía manual, define las cuatro líneas de modelo |
La primera respuesta tarda minutos, o aparece API error · Retrying in 0s | El modelo está leyendo la larga solicitud inicial de Claude Code, u Ollama sigue ocupado con una anterior | Espera: Claude Code reintenta solo. Mantén Ollama actualizado (desde la 0.33.1 retoma un arranque interrumpido) |
Olvida tu pedido, se detiene antes de tiempo o dice no user query found in messages | El contexto es demasiado pequeño, así que Ollama cortó el principio de la conversación | Pon 64K, revisa ollama ps y escribe /clear |
model requires more system memory ... than is available, o una división CPU/GPU en ollama ps | El modelo y su contexto no caben en la memoria gráfica | Elige un modelo más pequeño o uno en la nube, y cierra otras apps |
| "Invalid tool parameters" o "Error editing file" una y otra vez | El modelo escribe llamadas a herramientas mal formadas | Usa un modelo recomendado con 64K y actualiza Ollama |
403 ... this model requires a subscription | Ese modelo en la nube no está en el plan gratis | Usa gemma4:cloud, compra créditos o mejora tu plan |
Las filas de inicio de sesión y de conexión siguen la documentación de solución de problemas de gateways de Anthropic; para el resto, el registro de Ollama en Mac está en ~/.ollama/logs/server.log.
Claude Code con modelo local: otras opciones además de Ollama
LM Studio
La versión 0.4.1 agregó el mismo endpoint al estilo de Anthropic. Inicia su servidor en el puerto 1234 y apunta ANTHROPIC_BASE_URL ahí.
llama.cpp
Su llama-server también habla el formato de Anthropic y cuenta los tokens con exactitud, pero tú descargas los archivos del modelo y lo ejecutas.
OpenRouter
En la nube, no local: los modelos gratis se cortan en 50 solicitudes al día, y OpenRouter solo garantiza Claude Code con los modelos propios de Anthropic.
Claude Desktop en Mac
El menú Apps de la app de Ollama puede conectar Claude Desktop a modelos de Ollama, y al desconectarlo vuelve tu configuración.
Los detalles salen de la documentación de LM Studio y de OpenRouter. Si quieres un agente hecho para trabajar con cualquier modelo, lee Claude Code vs OpenCode.
Comprueba lo que sabes0 de 3 correctas
Configuraste Claude Code con Ollama y no deja de olvidar tu pedido. ¿Qué revisas primero?
No exactamente.
La mayoría de las computadoras arrancan Ollama con 4K o 32K tokens, y solo la solicitud inicial de Claude Code ocupó unos 20,000 tokens en nuestras pruebas, así que una ventana pequeña se llena rápido y Ollama corta el principio de la conversación.
Después de usar ollama launch claude, escribes claude a secas en una ventana nueva. ¿Qué modelo responde?
No exactamente.
El lanzador define sus variables solo para la sesión que abre y no cambia ninguna configuración de Claude Code.
¿Quién da soporte para usar Claude Code con modelos que no son de Claude?
No exactamente.
La documentación de Anthropic dice que no admite enrutar Claude Code a modelos que no sean de Claude; Ollama documenta y mantiene la integración.
Qué hacer ahora
Instala Ollama, sube el contexto a 64K y dale a qwen3.8:27b (o a qwen3.5:4b en una computadora más pequeña) nuestra tarea pequeña sobre una copia de una carpeta real. Mide el tiempo y revisa tú el resultado antes de confiarle más. Si la diferencia con Claude es demasiado grande para tu trabajo, compara planes en nuestra guía de precios de Claude Code, y si quieres un camino guiado con proyectos reales, el curso de Claude Code está abierto en acceso anticipado.
Kit de prueba de modelos locales para Claude Code
Un selector de modelo según tu memoria, tres tareas cronometradas con una lista para saber si pasan, todos los ajustes en una tabla y los pasos para volver a Claude o quitar Ollama.
Escribe tu correo y la sección completa se abre aquí mismo. Además recibes una clase gratis del curso.
Preguntas frecuentes
¿Necesito una cuenta de Claude para usar Claude Code con Ollama?
No. Cuando ANTHROPIC_AUTH_TOKEN está definida antes de que arranque Claude Code, algo que ollama launch claude hace por ti, Claude Code se salta el inicio de sesión de Claude y envía cada solicitud a Ollama. Las funciones que necesitan una sesión de claude.ai, como Remote Control, las sesiones en la nube y el dictado por voz, no están disponibles en esa sesión.
¿Claude Code funciona sin internet con Ollama?
Con un modelo local, sí: una vez que Ollama y el modelo están en tu computadora, el modelo no necesita conexión a internet. Claude Code sigue intentando conectarse con Anthropic para buscar actualizaciones y enviar métricas de uso, salvo que definas CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, y la búsqueda web o abrir una página web necesitan conexión.
¿Cómo vuelvo a usar los modelos de Claude en Claude Code?
Ejecuta claude a secas en una ventana nueva de la terminal. ollama launch claude define sus variables solo para la sesión que abre, así que tu plan de Claude no cambia; si exportaste las variables tú mismo, cierra esa ventana o quítalas del perfil de tu shell.
¿Puedo usar Claude Code con Ollama en VS Code?
Sí. Pon las mismas variables (ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN y los nombres de los modelos) en claudeCode.environmentVariables, dentro de la configuración de usuario de VS Code, y reinicia el panel de Claude Code. La extensión de Ollama para VS Code es otra cosa: agrega los modelos de Ollama al chat integrado de VS Code.
¿Puedo usar modelos de Ollama en la app de escritorio de Claude?
En Mac, sí: abre la app de Ollama, elige Apps y conecta Claude, y Ollama configura Claude Desktop para que use sus modelos; al desconectarlo vuelve tu configuración normal. Ollama indica que el soporte para Windows llegará pronto.
Sigue leyendo
Claude Code vs OpenCode (2026): costo, modelos y privacidad
Claude Code vs OpenCode en octubre de 2026: benchmarks, costos reales, por qué Claude Pro no sirve en OpenCode, modelos locales, privacidad e instalación.
Claude Code · 13 min de lecturaPrecios de Claude Code 2026: Pro vs Max, API y cuál elegir
Precios de Claude Code revisados en octubre de 2026: Pro vs Max, Team, Enterprise y API por token, si es gratis, cuánto cuesta al mes y qué plan elegir.
Claude Code · 17 min de lecturaInstalar Claude Code en Windows y Mac: paso a paso (2026)
Descarga e instala Claude Code en Windows o Mac paso a paso, sin programar: instalador oficial o app de escritorio, primera tarea segura y errores comunes.
Claude Code · 18 min de lectura