Claude Code avec Ollama : modèles locaux gratuits (2026)
Configurez Claude Code avec un modèle ouvert et gratuit via Ollama en quatre étapes, choisissez celui adapté à votre machine et découvrez nos mesures sur un Mac de 48 Go en octobre 2026.
Par Yotam DahanMis à jour 20 min de lectureClaude Code
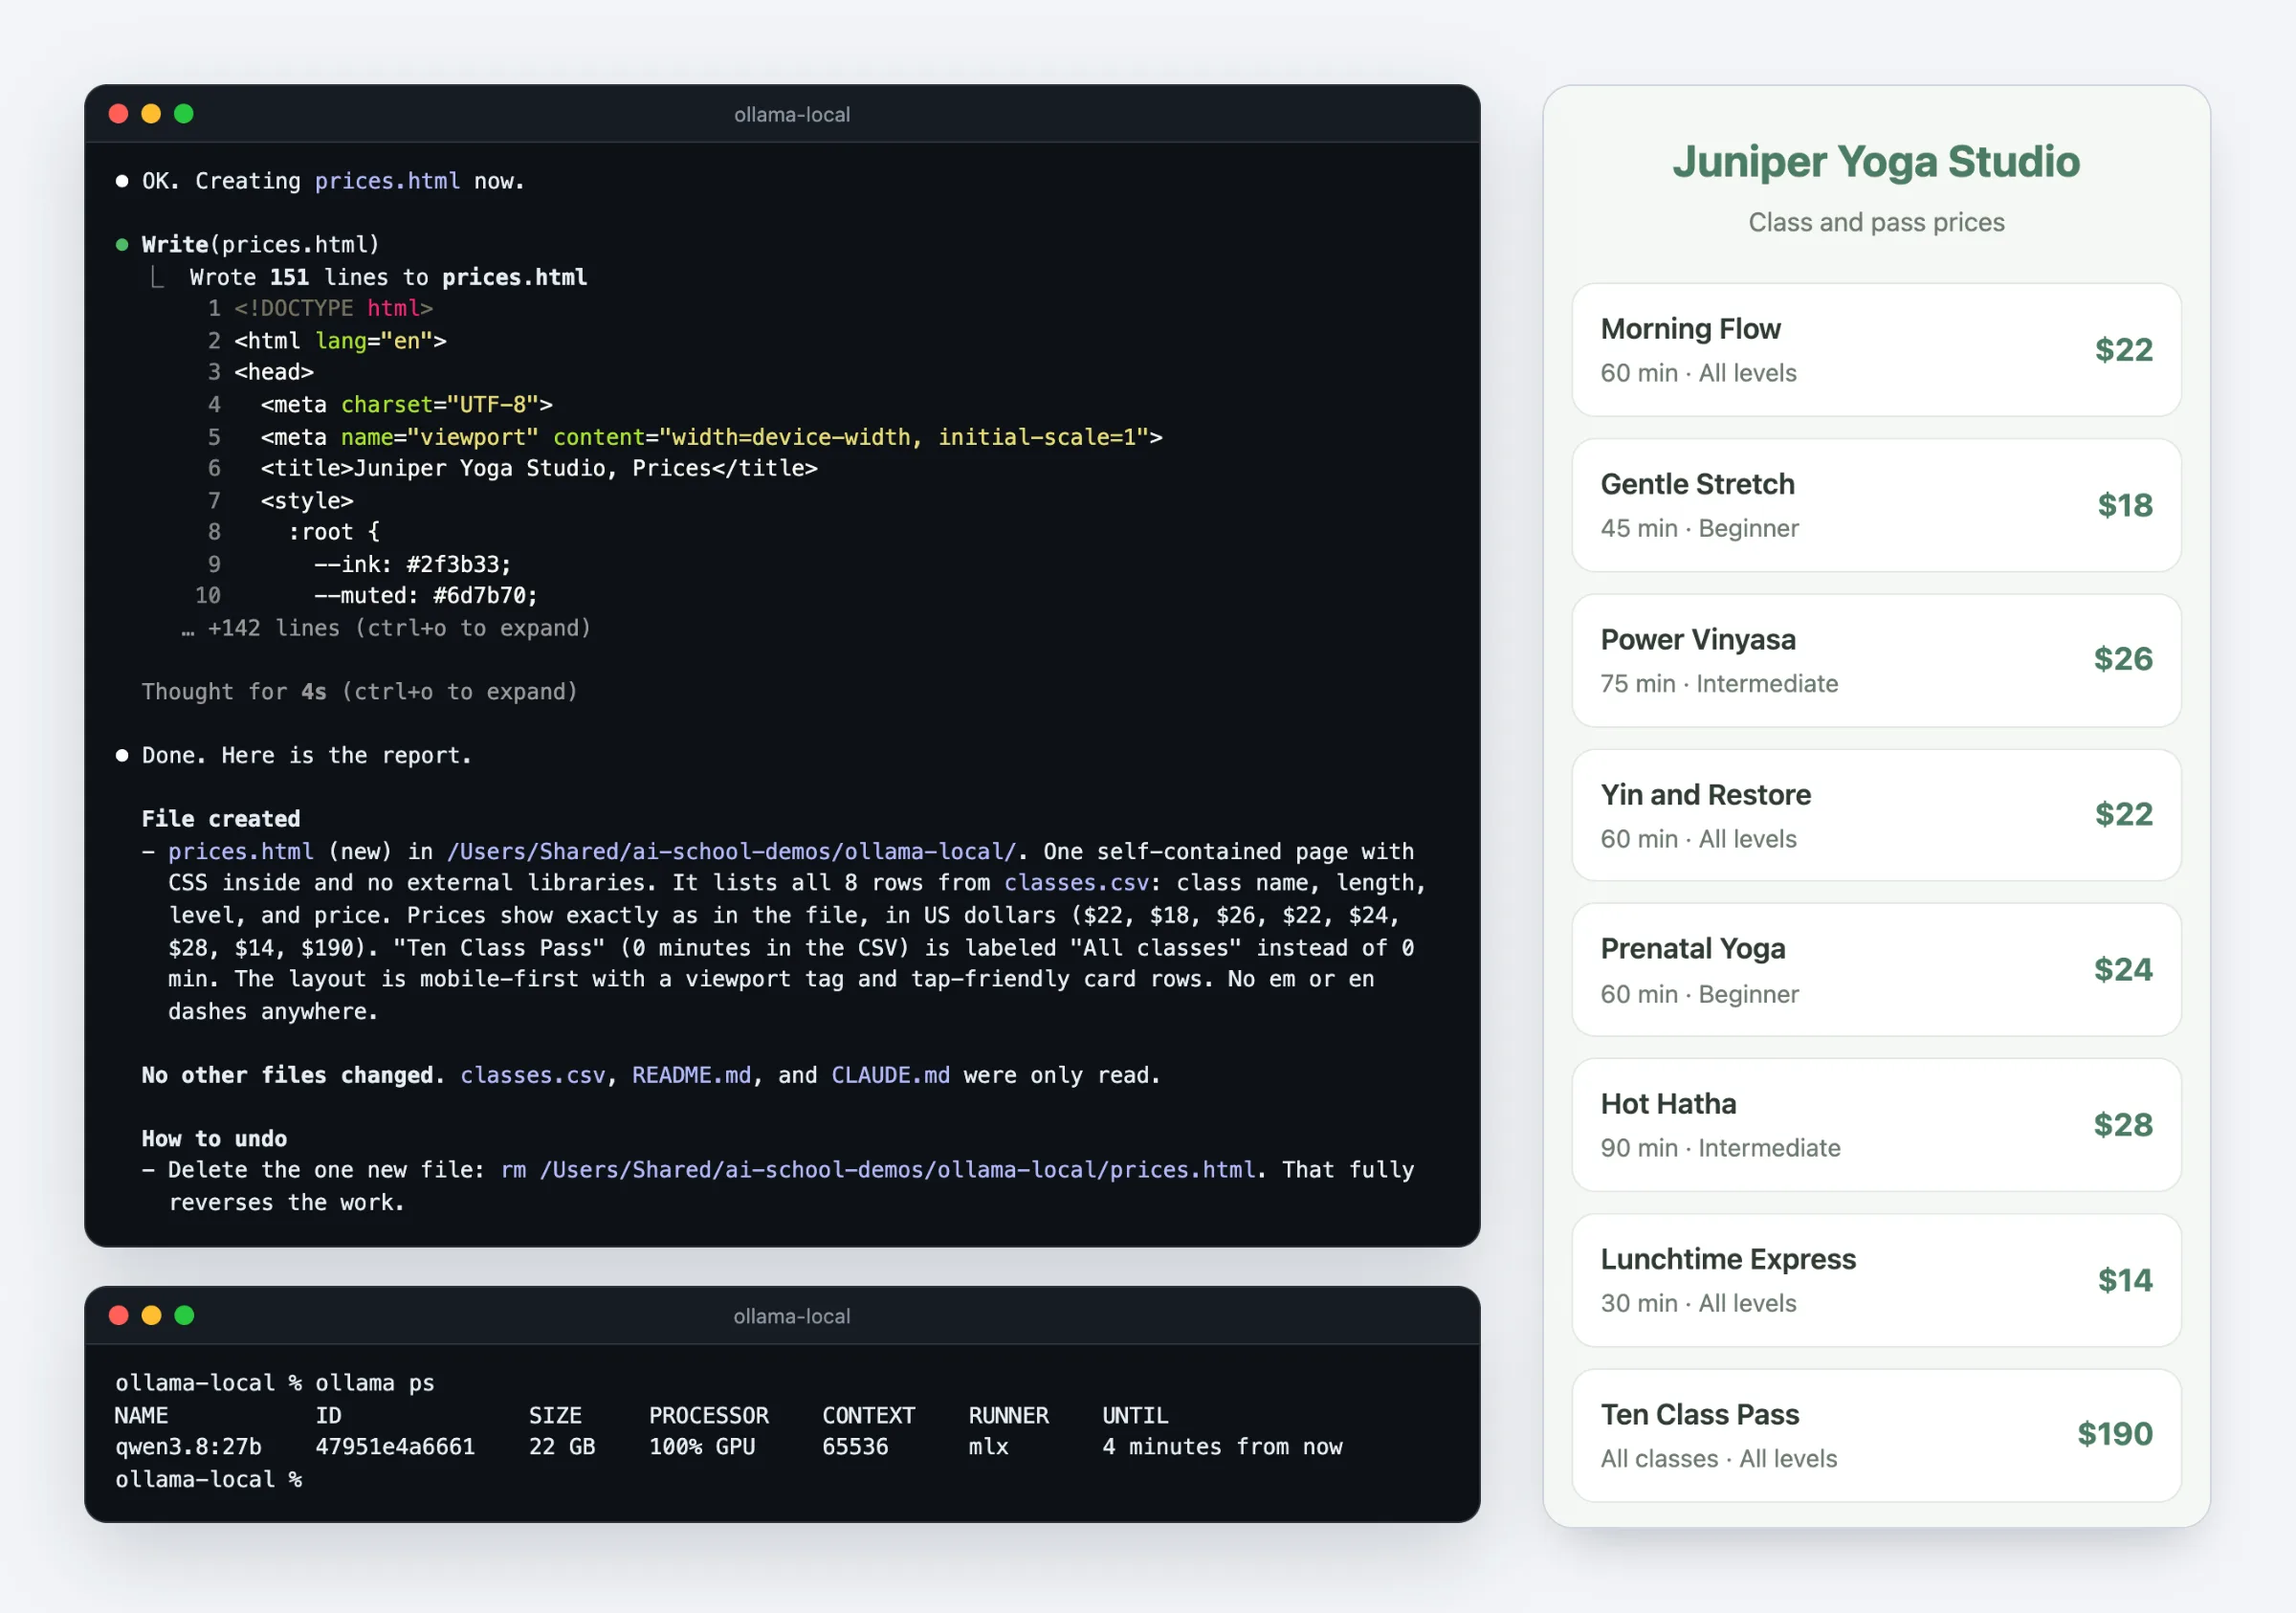
Utiliser Claude Code avec Ollama, c'est faire tourner Claude Code sur un modèle ouvert et gratuit, sur votre propre ordinateur, au lieu de Claude : installez Ollama, passez sa longueur de contexte à 64K et lancez ollama launch claude. Cela fonctionne, mais c'est une configuration d'Ollama, pas d'Anthropic : Anthropic ne prend pas en charge Claude Code sur des modèles autres que Claude, et un modèle local est bien plus faible et plus lent que Claude. Réservez-le aux essais privés et aux tâches simples, pas au remplacement pur et simple d'un forfait Claude.
Comment Claude Code fonctionne avec Ollama
Claude Code est l'agent : le programme qui lit vos fichiers, lance des commandes et vous demande la permission avant de modifier quoi que ce soit. Le modèle, c'est le cerveau derrière, normalement Claude sur les serveurs d'Anthropic.
Depuis la version 0.14.0, sortie en janvier 2026 (d'après les notes de version d'Ollama), Ollama répond dans le même format de messages que l'API d'Anthropic, sur votre propre ordinateur, sur le port 11434. Faites pointer Claude Code vers ce port et il fonctionne avec un modèle ouvert (un modèle que tout le monde peut télécharger et faire tourner). Claude Code lui-même ne change pas, et il reste soumis aux conditions d'Anthropic, quel que soit le modèle derrière.
Vous
Demandez une modification à Claude Code, en français courant
Claude Code
Lit vos fichiers et envoie la demande à Ollama sur le port 11434
Ollama
Fait tourner le modèle ouvert sur la puce graphique de votre ordinateur
Vos fichiers
Claude Code applique les modifications que le modèle demande, avec votre permission
Ce qu'il vous faut
La mémoire décide presque de tout : un modèle doit tenir dans la mémoire que votre puce graphique peut utiliser, avec de la place pour la conversation, sinon il se traîne. Vous n'avez besoin ni d'un forfait Claude ni d'une clé API, et Ollama peut installer Claude Code pour vous (sinon, voyez comment installer Claude Code). Par où commencer pour faire tourner Claude Code en local :
| Votre ordinateur | Commencez par | Téléchargement | Mémoire indiquée par Ollama |
|---|---|---|---|
| 16 Go ou moins | qwen3.5:4b | 3,3 à 4,0 Go | Environ 6 Go |
| 24 à 32 Go | gemma4:12b | 7,7 à 8,0 Go | Environ 11 Go |
| 48 Go ou plus | qwen3.8:27b | 18 Go | Environ 28 Go |
| N'importe quel ordinateur, avec un compte ollama.com | gemma4:cloud | Rien | Tourne sur les serveurs d'Ollama |
Les indications de mémoire sont celles qu'affiche le lanceur d'Ollama, et les tailles de téléchargement viennent de la bibliothèque d'Ollama, toutes vérifiées le 22 octobre 2026. Sur un PC, comparez l'indication à la mémoire de votre carte graphique. L'application Mac pèse environ 214 Mo.
Étape 1 : installer Ollama sur Mac, Windows ou Linux
Pour installer Claude Code avec Ollama, tout commence par l'installateur disponible sur ollama.com/download : une application qui fait tourner un petit serveur en arrière-plan, plus la commande ollama.
- Mac (macOS 14 ou plus récent) : téléchargez Ollama.dmg, glissez Ollama dans Applications et ouvrez-le ; il propose d'ajouter la commande
ollamaà votre terminal. - Windows 10 (22H2) ou 11 : lancez OllamaSetup.exe, qui ne demande pas de droits d'administrateur.
- Linux : lancez le script d'installation ci-dessous ; il installe Ollama comme service en arrière-plan.
- Vérifiez : ouvrez une nouvelle fenêtre de terminal et lancez
ollama -v.
Les installateurs officiels en une ligne, pour Mac ou Linux :
curl -fsSL https://ollama.com/install.sh | sh
Sur Windows, dans PowerShell :
irm https://ollama.com/install.ps1 | iex
ollama -v
ollama version is 0.40.8
Sur Windows, les cartes NVIDIA demandent le pilote 551.61 ou plus récent, et les cartes AMD Radeon passent par ROCm ou Vulkan, d'après la documentation Windows d'Ollama.
Étape 2 : régler la longueur de contexte sur 64K
La longueur de contexte, c'est la quantité de conversation que le modèle peut voir d'un coup, comptée en tokens (de petits morceaux de texte). La seule requête d'ouverture de Claude Code, c'est-à-dire ses instructions plus la description de chaque outil, faisait environ 20 300 tokens dans nos essais sans plugin, et des utilisateurs signalent jusqu'à 36 000. Voilà pourquoi Ollama demande 64K.
Ollama choisit une valeur par défaut d'après votre mémoire graphique, et la plupart des ordinateurs tombent en dessous. Sur Mac, il compte la part de mémoire que la puce graphique peut utiliser, et le journal de notre MacBook Pro de 48 Go montre le résultat : vram-based default context total_vram="37.4 GiB" default_num_ctx=32768, soit 32K.
par défaut sous 24 Go de mémoire graphique
par défaut de 24 à 48 Go, dont notre Mac de 48 Go
par défaut à partir de 48 Go
ce qu'Ollama demande pour Claude Code
Paliers tirés de la documentation d'Ollama sur la longueur de contexte, vérifiée le 22 octobre 2026. Les 32K de notre Mac viennent de son propre journal Ollama.
Vous pouvez augmenter la longueur de contexte de quatre façons, toutes côté Ollama :
- L'application Ollama (Mac et Windows) : ouvrez Settings (réglages) et réglez Context length (longueur de contexte) sur 64k, que l'application enregistre comme 65 536 tokens.
- Un terminal, application fermée : lancez
OLLAMA_CONTEXT_LENGTH=65536 ollama serveet laissez la fenêtre ouverte (c'est ce que nous avons fait). - Un service Linux : lancez
sudo systemctl edit ollama, ajoutez les deux lignes ci-dessous, puis redémarrez le service. - Un seul modèle, sur n'importe quel système : enregistrez une copie du modèle avec une fenêtre plus grande et utilisez son nouveau nom (ici
qwen3.8-64k) à la place deqwen3.8:27b.
[Service]
Environment="OLLAMA_CONTEXT_LENGTH=65536"sudo systemctl daemon-reload && sudo systemctl restart ollama
Pour la copie, mettez ces deux lignes dans un fichier texte brut nommé Modelfile (le Bloc-notes fait l'affaire), puis créez le modèle depuis ce dossier :
FROM qwen3.8:27b
PARAMETER num_ctx 65536ollama create qwen3.8-64k -f Modelfile
Chargez ensuite un modèle et vérifiez ce qu'Ollama lui a vraiment attribué :
ollama ps
NAME ID SIZE PROCESSOR CONTEXT RUNNER UNTIL
qwen3.8:27b 47951e4a6661 22 GB 100% GPU 65536 mlx 4 minutes from now
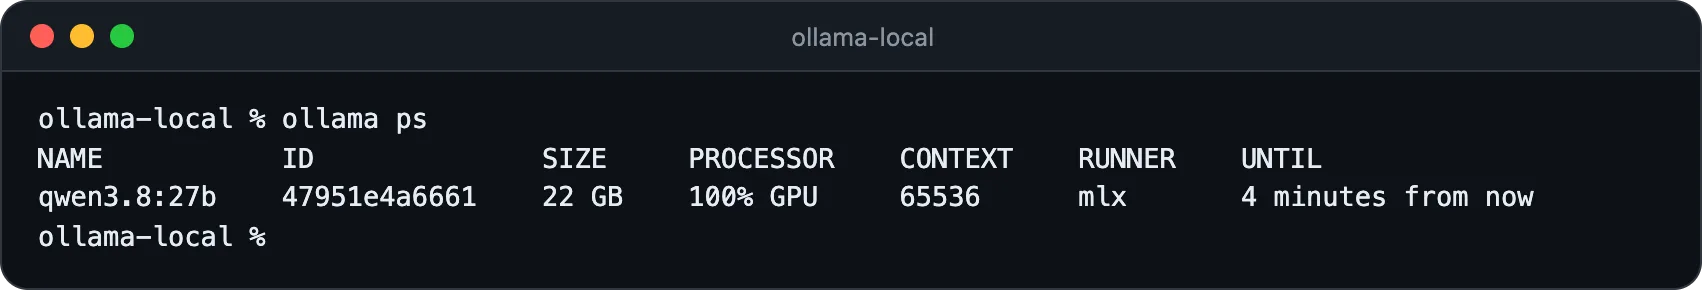
CONTEXT doit afficher 64K ou plus, et PROCESSOR 100% GPU ; une répartition comme 48%/52% CPU/GPU signifie qu'une partie du modèle a débordé dans une mémoire plus lente. Sur Mac, RUNNER mlx désigne le moteur MLX d'Apple.
Étape 3 : démarrer Claude Code avec ollama launch claude
Ouvrez un terminal dans le dossier sur lequel Claude Code doit travailler (Terminal sur Mac, PowerShell sur Windows) et lancez :
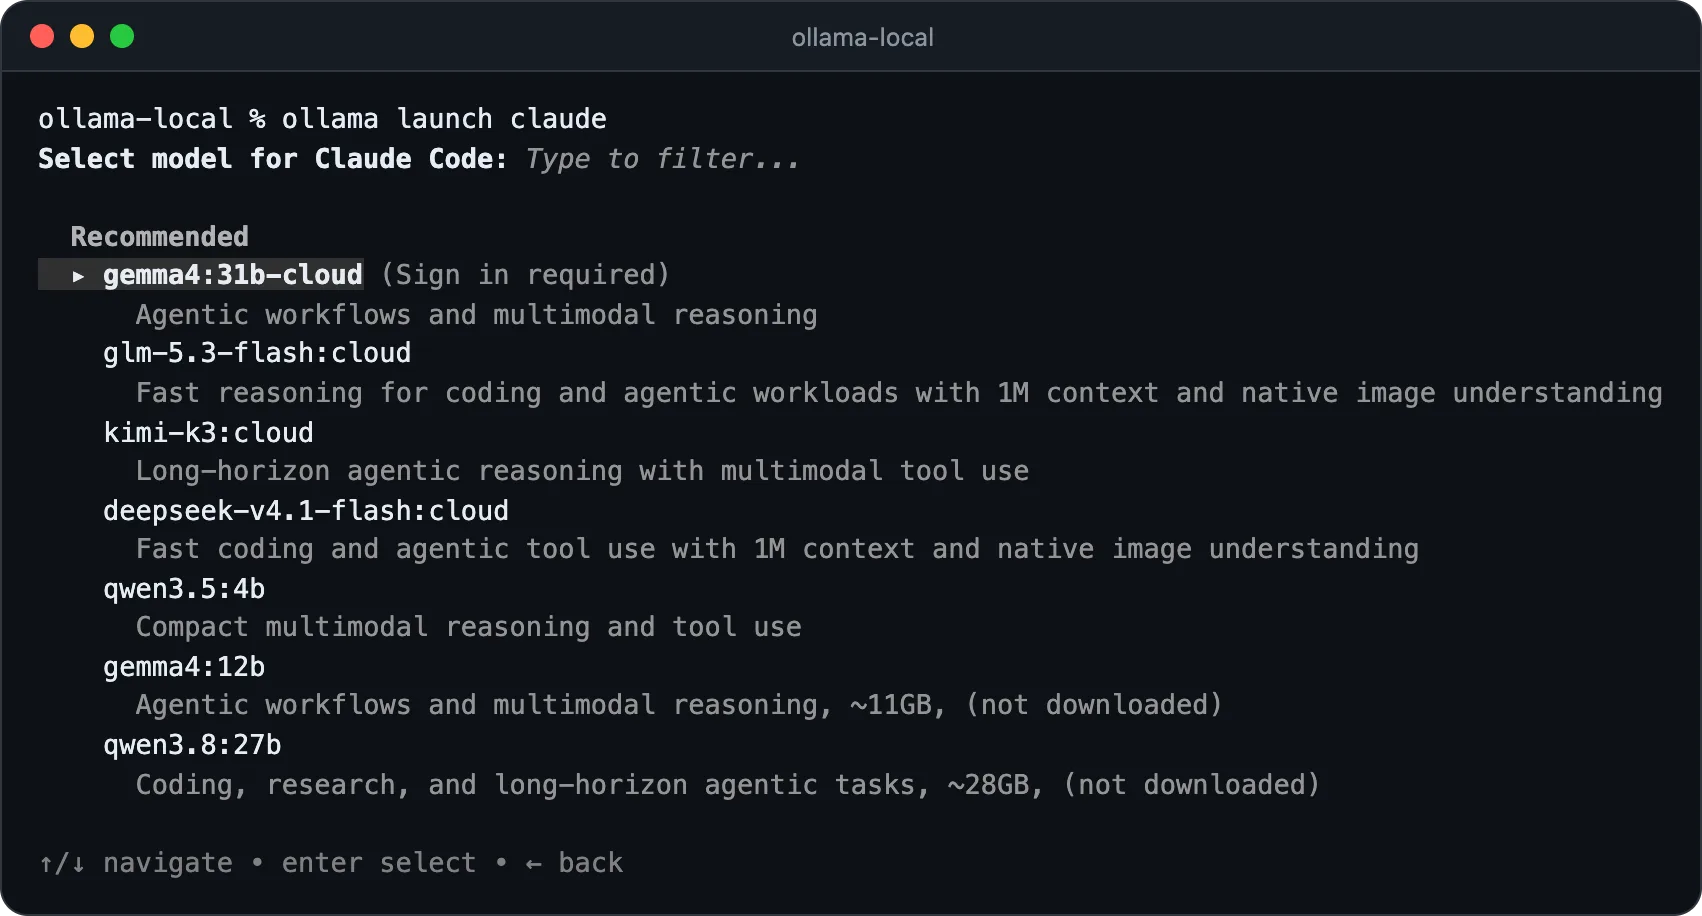
ollama launch claude
- Choisissez un modèle. Sous « Recommended » (recommandés), la liste affiche d'abord les modèles cloud d'Ollama (ils demandent une connexion à ollama.com), puis les modèles locaux avec la mémoire qu'il leur faut, marqués « not downloaded » (pas téléchargé) tant que vous ne les avez pas.
- Laissez-le télécharger. Si le modèle n'est pas encore sur votre ordinateur, Ollama le télécharge d'abord. Les 18 Go de qwen3.8:27b ont pris 6 minutes 43 secondes avec notre connexion.
- Installez Claude Code si on vous le propose. S'il manque, Ollama demande « Claude Code is not installed. Install now? » (Claude Code n'est pas installé, l'installer maintenant ?) et lance l'installateur officiel d'Anthropic.
- Faites confiance au dossier. Au premier lancement, Claude Code demande un thème et si vous faites confiance au dossier, sans écran de connexion. Ensuite, l'en-tête affiche le modèle qui répond :
qwen3.8:27b · API Usage Billing.
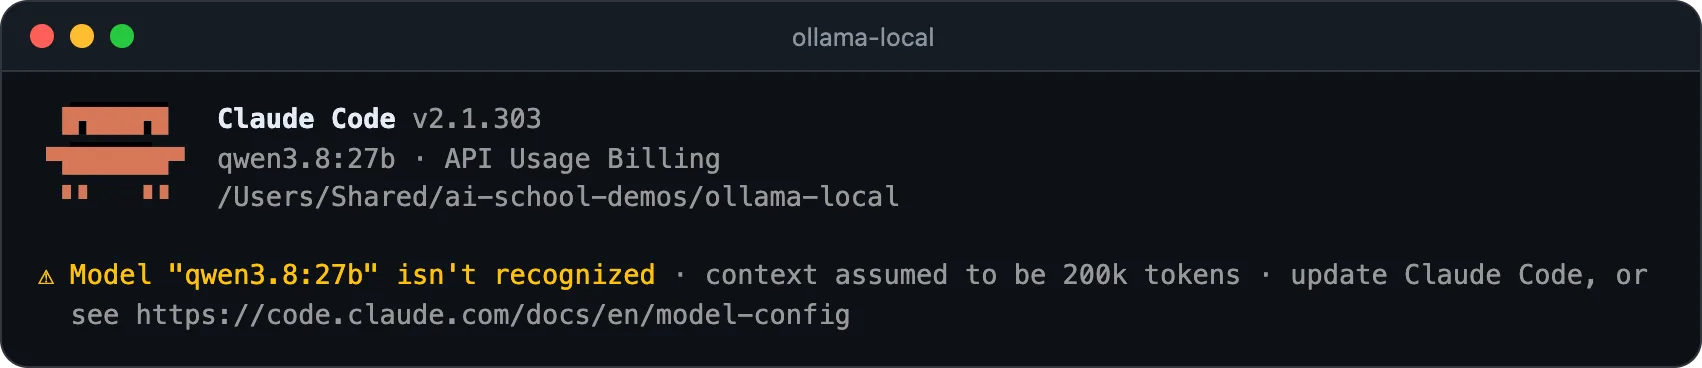
Cette ligne jaune compte. Claude Code connaît la taille de contexte des modèles Claude, pas celle de qwen3.8:27b : il a donc affiché Model "qwen3.8:27b" isn't recognized · context assumed to be 200k tokens, comme le décrit la documentation d'Anthropic sur la configuration des modèles, et il attendrait bien trop longtemps avant de compacter (résumer) une longue conversation. Démarrez-le avec une taille juste en dessous de celle d'Ollama et l'avertissement disparaît :
CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000 ollama launch claude --model qwen3.8:27b
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
ollama launch claude --model qwen3.8:27b
Pour cette seule session, le lanceur fait pointer Claude Code vers Ollama avec un jeton factice, si bien qu'aucune connexion à Claude n'est nécessaire, et il envoie chaque emplacement de modèle, agents assistants compris, vers votre modèle. Il n'écrit aucun réglage de Claude Code : un simple claude dans une nouvelle fenêtre vous ramène sur votre forfait Claude. --yes (avec --model) saute toutes les questions, et tout ce qui suit -- est transmis à Claude Code, comme dans ollama launch claude --model qwen3.8:27b -- --resume.
La voie manuelle : les variables d'environnement
Pour démarrer plutôt avec un simple claude, définissez les variables vous-même. La documentation Claude Code d'Ollama liste les trois premières ; les lignes de modèles sont celles qu'ajoute le lanceur, car sinon certains assistants de Claude Code demandent un modèle Claude à Ollama et reçoivent « model not found » (modèle introuvable). Sur Mac ou Linux :
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3.8:27b
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3.8:27b
export CLAUDE_CODE_SUBAGENT_MODEL=qwen3.8:27b
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000
claude --model qwen3.8:27b
Sur Windows, dans PowerShell :
$env:ANTHROPIC_BASE_URL = "http://localhost:11434"
$env:ANTHROPIC_AUTH_TOKEN = "ollama"
Remove-Item Env:ANTHROPIC_API_KEY -ErrorAction SilentlyContinue
$env:ANTHROPIC_DEFAULT_OPUS_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_SONNET_MODEL = "qwen3.8:27b"
$env:ANTHROPIC_DEFAULT_HAIKU_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_SUBAGENT_MODEL = "qwen3.8:27b"
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS = "64000"
claude --model qwen3.8:27b
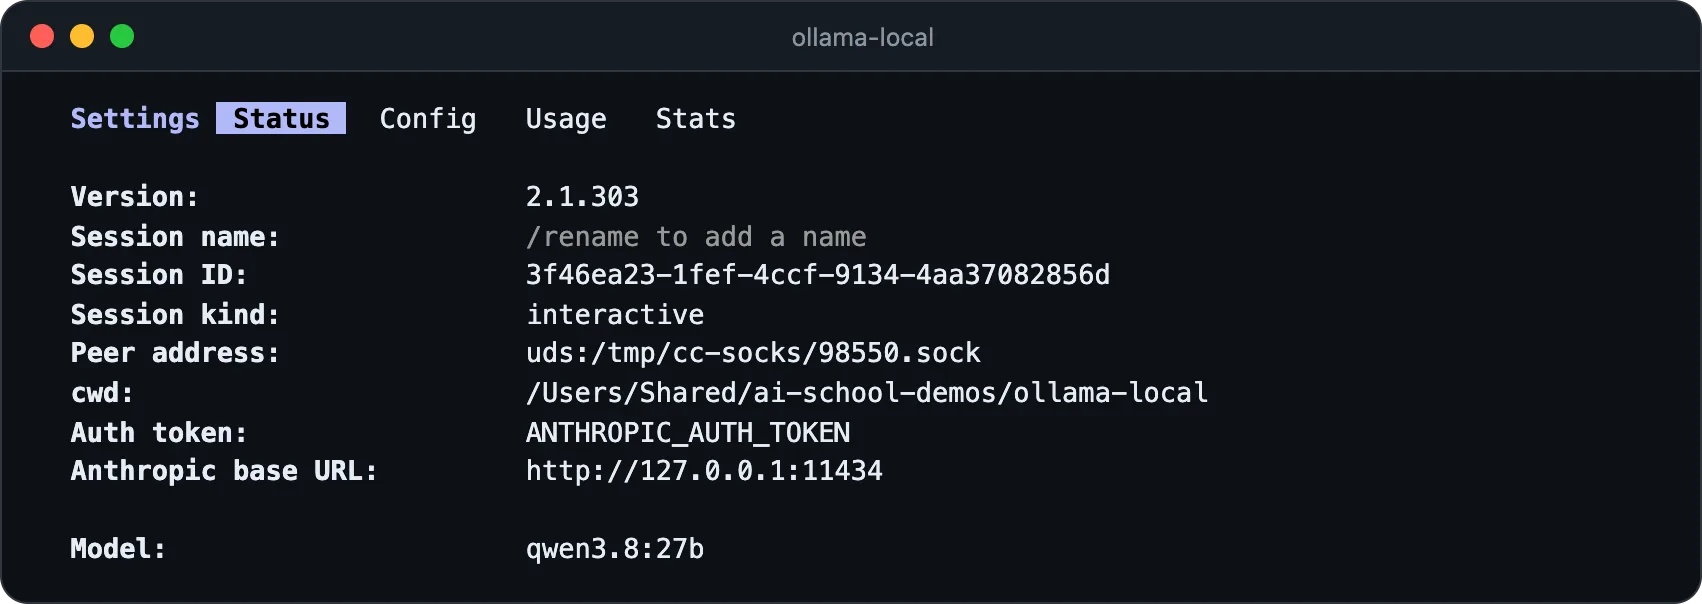
PowerShell ne sait pas garder une variable vide, donc la version Windows supprime ANTHROPIC_API_KEY, avec le même effet. Ces réglages durent jusqu'à la fermeture de la fenêtre. Pour vérifier l'une ou l'autre voie, tapez /status : la ligne du jeton d'authentification doit nommer ANTHROPIC_AUTH_TOKEN, et l'URL de base doit désigner votre propre ordinateur sur le port 11434.
Quel est le meilleur modèle Ollama pour Claude Code ?
Les modèles Ollama que le lanceur recommande pour Claude Code changent avec le temps. Le 22 octobre 2026, les choix locaux étaient les trois du tableau plus haut : tous savent appeler des outils, ce dont Claude Code dépend (lire un fichier, le modifier, lancer une commande), tous montent à un contexte maximal de 256K et tous sont sous licence Apache 2.0. Les choix cloud :
| Modèle cloud | Contexte | Offre |
|---|---|---|
gemma4:cloud | 256K | Crédits de démarrage de l'offre gratuite |
glm-5.3-flash:cloud | 1M | Pro ou crédits achetés |
kimi-k3:cloud | 1M | Pro ou crédits achetés |
deepseek-v4.1-flash:cloud | 1M | Pro ou crédits achetés |
Passons à la partie honnête. Terminal-Bench 4.0 est un ensemble de vraies tâches en terminal qu'Artificial Analysis fait passer de la même façon à chaque modèle :
D'après Artificial Analysis, vérifié le 22 octobre 2026. Ce sont les modèles complets, hébergés ; les versions compressées que vous téléchargez sur un portable ne devraient pas faire mieux. Gemma 4 n'a pas de score sur ce test.
GLM-5.3-Flash et DeepSeek V4.1 Flash, tous deux sur le cloud d'Ollama, obtiennent environ six fois le score de Qwen3.8 27B, et Claude reste loin devant tous les autres. Notre classement des modèles d'IA donne une vue plus large.
Ce que nous avons vu sur un Mac de 48 Go
Pour mesurer l'écart sur une petite tâche réelle, j'ai fait tourner le duo Ollama + Claude Code avec les deux modèles locaux, sur la liste de cours d'un studio de yoga fictif et avec le prompt de test de notre comparatif des agents IA pour coder, que vous pouvez lancer sur vos propres fichiers :
Travaille uniquement dans ce dossier. Lis [FICHIER AVEC VOS PRIX OU SERVICES] et crée une grille de tarifs sur une seule page, appelée prices.html, lisible sur téléphone. Avant de modifier quoi que ce soit, donne-moi ton plan en trois points et attends mon accord. Quand tu as terminé, liste chaque fichier créé ou modifié et explique-moi comment annuler.| Modèle et contexte | Première réponse après | Tâche complète | Page réussie ? | Erreurs d'outils |
|---|---|---|---|---|
| qwen3.8:27b, 64K | 3 min 27 s | 5 min 30 s | Oui | 0 |
| qwen3.5:4b, 64K | 43 s | 1 min 39 s | En partie | 0 |
| qwen3.5:4b, 32K par défaut, premier essai | 7 min 10 s, après une erreur d'API | 8 min 7 s | En partie | 0, plus 1 nouvelle tentative automatique |
tokens par seconde écrits, qwen3.8:27b
tokens par seconde écrits, qwen3.5:4b
tokens par seconde lus par qwen3.8:27b, environ
de mémoire utilisée par qwen3.8:27b après la tâche
Nos mesures sur un MacBook Pro M4 Pro de 48 Go, Ollama 0.40.8, 22 octobre 2026. Les vitesses d'écriture viennent de lancements à chaud de ollama run --verbose ; la vitesse de lecture vient du journal d'Ollama pour la requête d'ouverture de Claude Code. Les durées comptent le travail du modèle, pas notre temps de frappe.
qwen3.8:27b a réussi : une page propre, les huit prix exacts, un plan juste, aucune erreur d'outil. Sa première réponse a pris 3 minutes 27 secondes parce qu'il a lu la requête d'ouverture de Claude Code, 20 300 tokens, à environ 117 tokens par seconde ; ensuite, le cache d'Ollama a rendu chaque étape rapide.
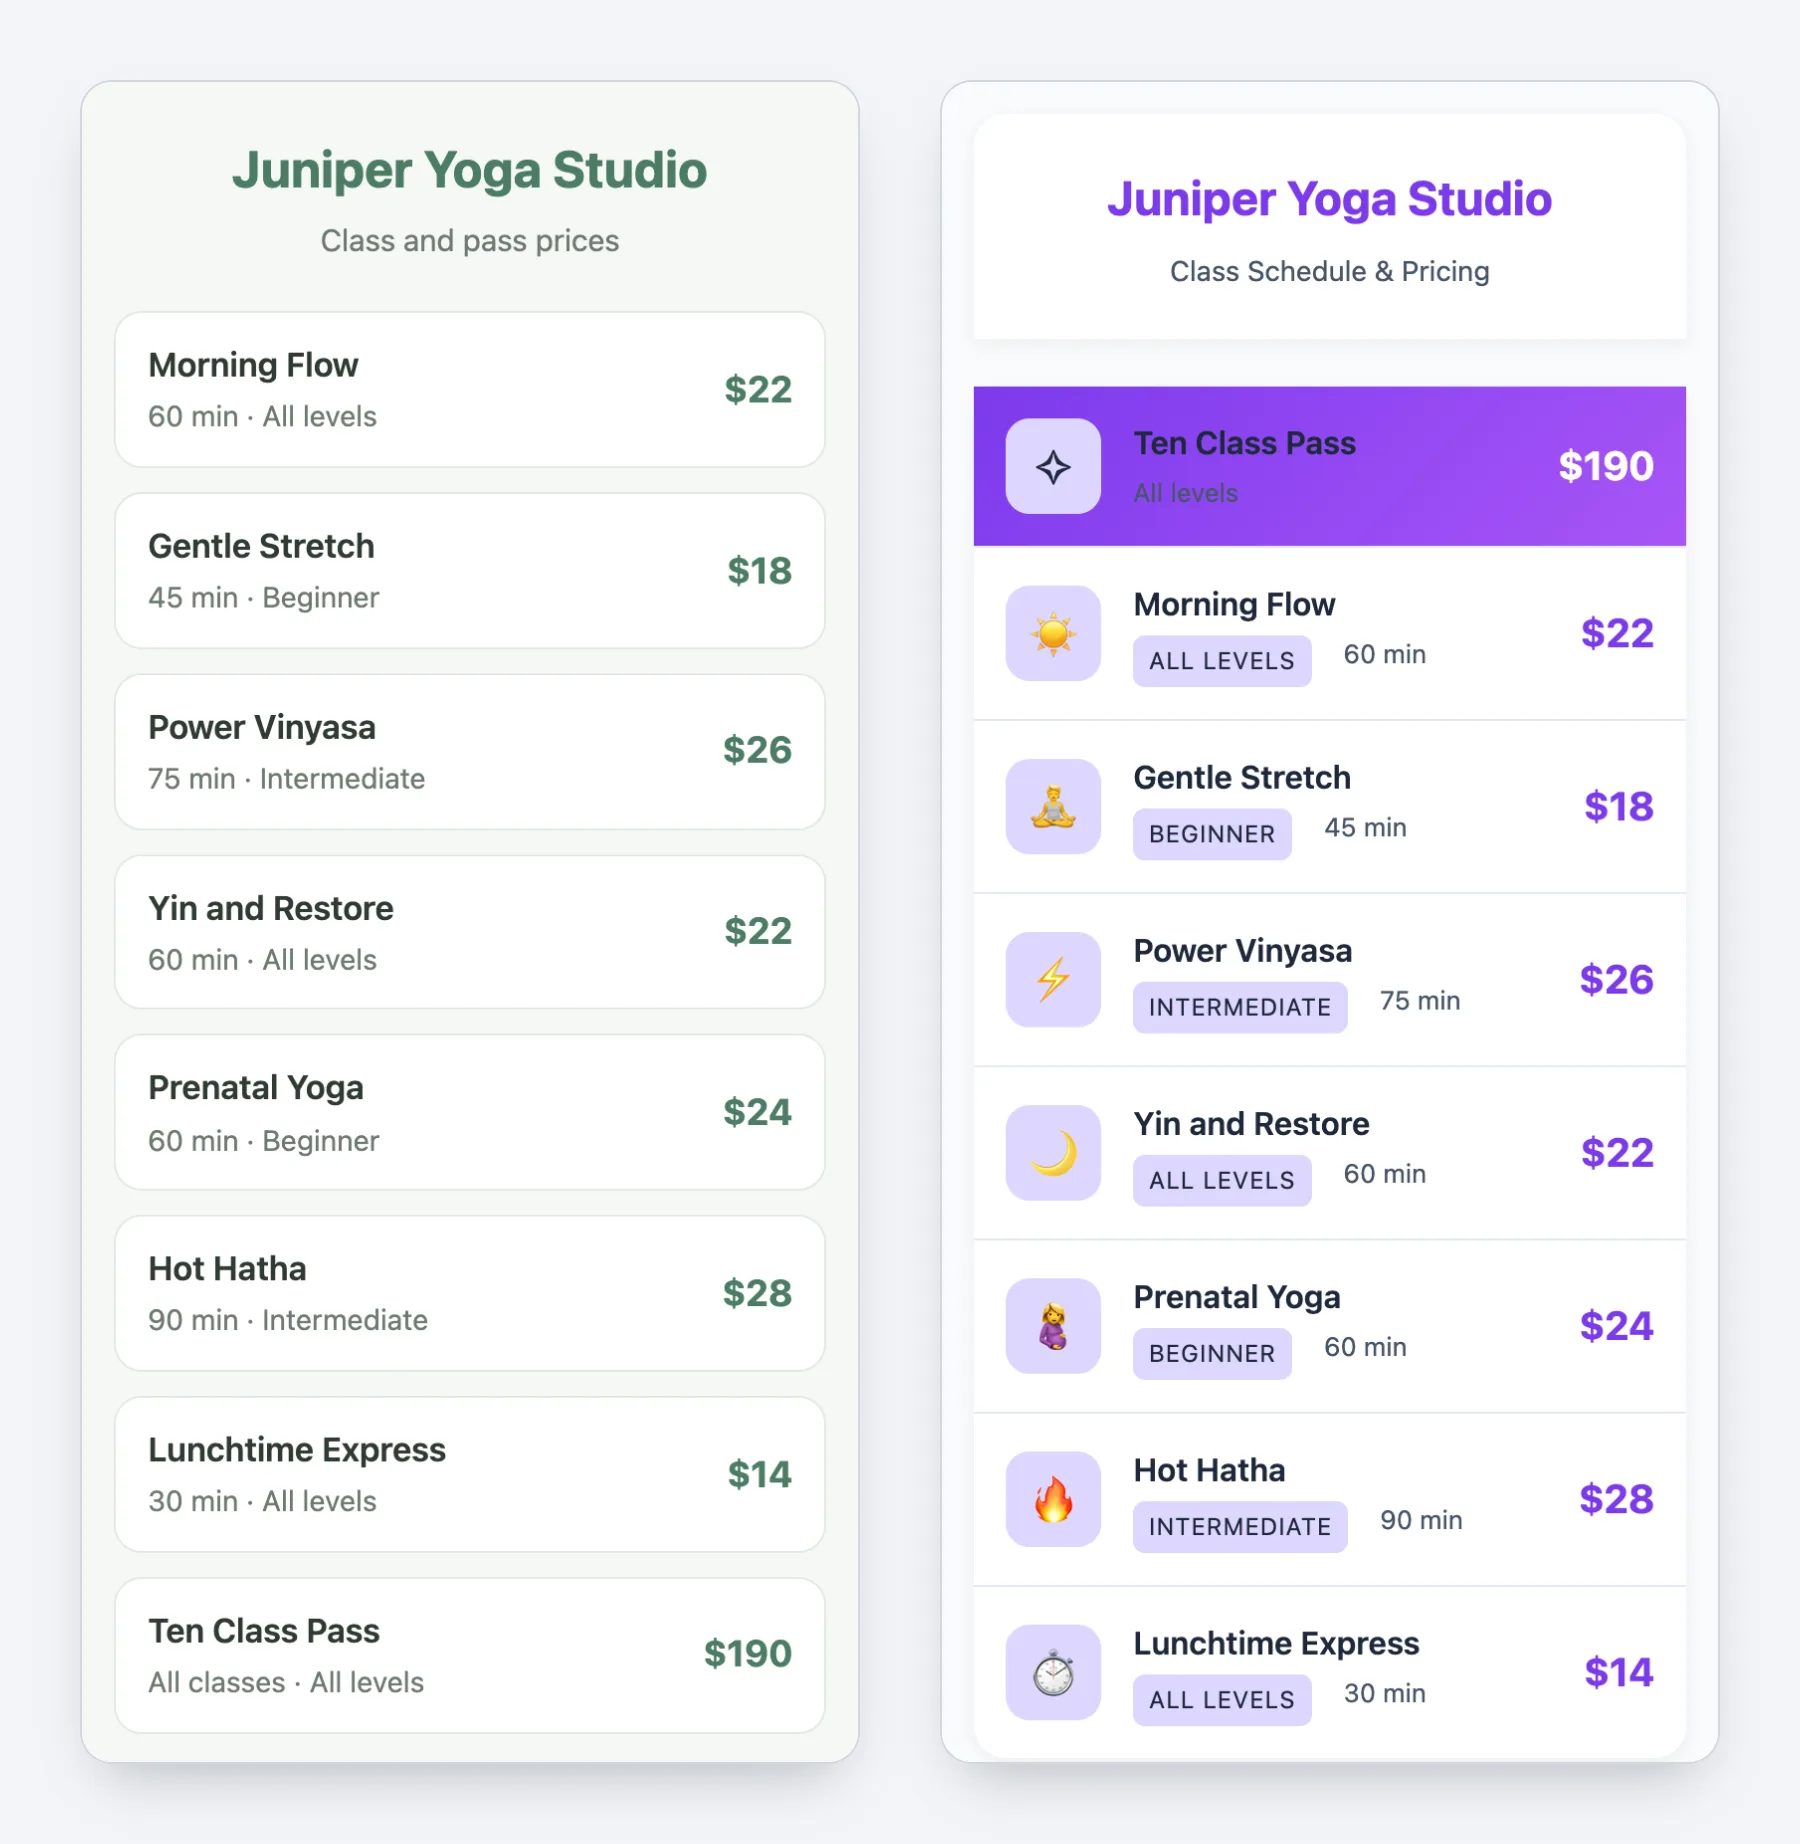
qwen3.5:4b a lu la même requête en environ 28 secondes et a fini en moins de deux minutes, mais c'est une démo rapide, pas un travailleur fiable : les bons prix, une ligne difficile à lire, et dans sa réponse un tiret cadratin, que le CLAUDE.md du dossier interdit. Lors de son premier essai, avec le contexte par défaut de 32K, son plan affichait un cours à 29 $ (le fichier indique 28 $), après ceci :
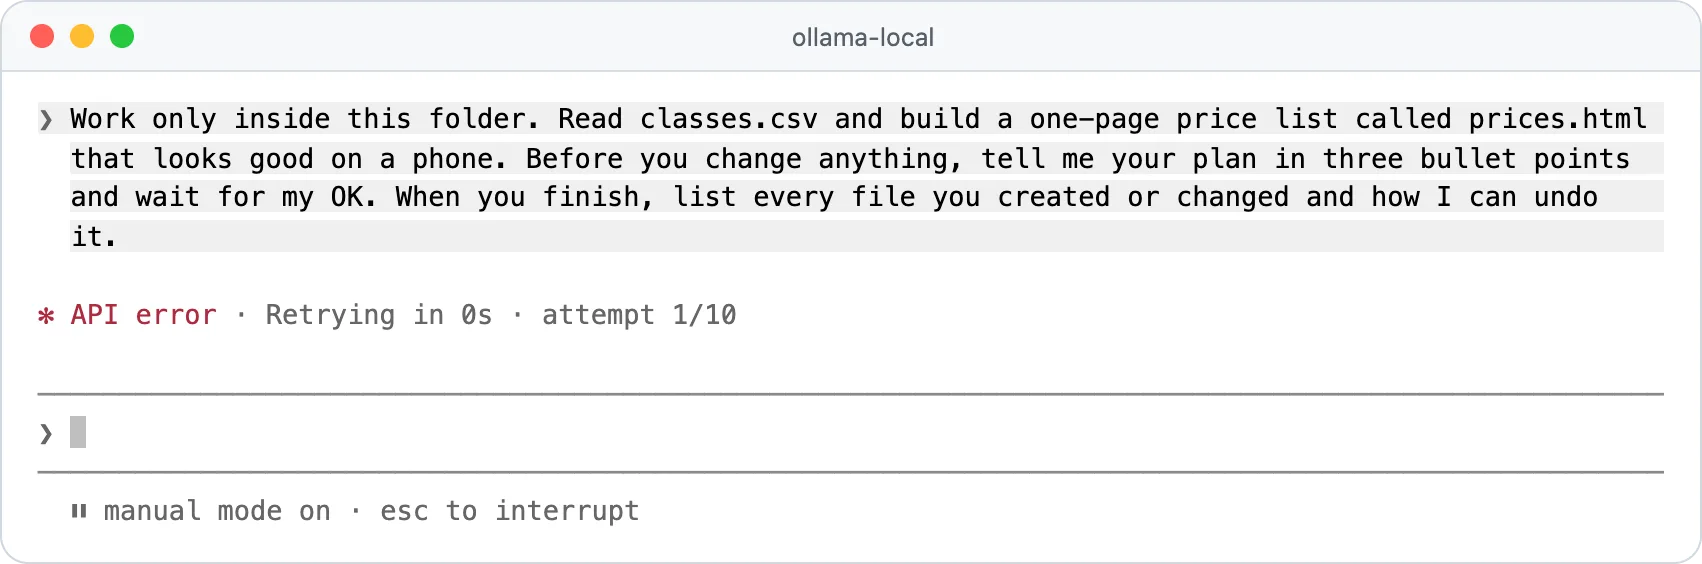
Ollama a renvoyé une erreur HTTP 500 au bout de 5 minutes 22 secondes, alors que le modèle était encore occupé par une petite requête annexe ; Claude Code a affiché API error · Retrying in 0s · attempt 1/10 et a réessayé de lui-même. Nous n'avons rien corrigé à la main, dans aucun essai.
Ce qui ne marche plus sans Claude
L'agent est le même programme, donc l'essentiel de Claude Code continue de fonctionner. Ce qui dépend des serveurs d'Anthropic ou d'une connexion à Claude change :
Fonctionne
Lire et modifier des fichiers, lancer des commandes avec votre permission, les plans que vous validez, et les agents assistants, qu'Ollama prend en charge.
Change
La recherche web de Claude est désactivée. Avec les modèles cloud d'Ollama, la recherche web d'Ollama prend le relais, ce qui demande un compte ollama.com.
Disparaît
Remote Control, la dictée vocale, les sessions cloud et l'onglet Code de l'application de bureau, qui demandent tous une connexion à Claude.
Moins fluide
Pas de cache de prompts d'Anthropic, des nombres de tokens estimés dans /context, pas de lecture de PDF, et un modèle qui peut ignorer les règles de votre CLAUDE.md.
Sources : la page d'Anthropic sur la disponibilité des fonctions et la liste de compatibilité Anthropic d'Ollama.
Les modèles cloud d'Ollama pour Claude Code
Les modèles dont le nom finit par :cloud tournent sur les serveurs d'Ollama : rien à télécharger, pas besoin d'une puce graphique puissante, et des scores bien plus élevés. Le revers : ils demandent un compte ollama.com (ollama signin), et vos prompts quittent votre ordinateur.
ollama launch claude --model gemma4:cloud
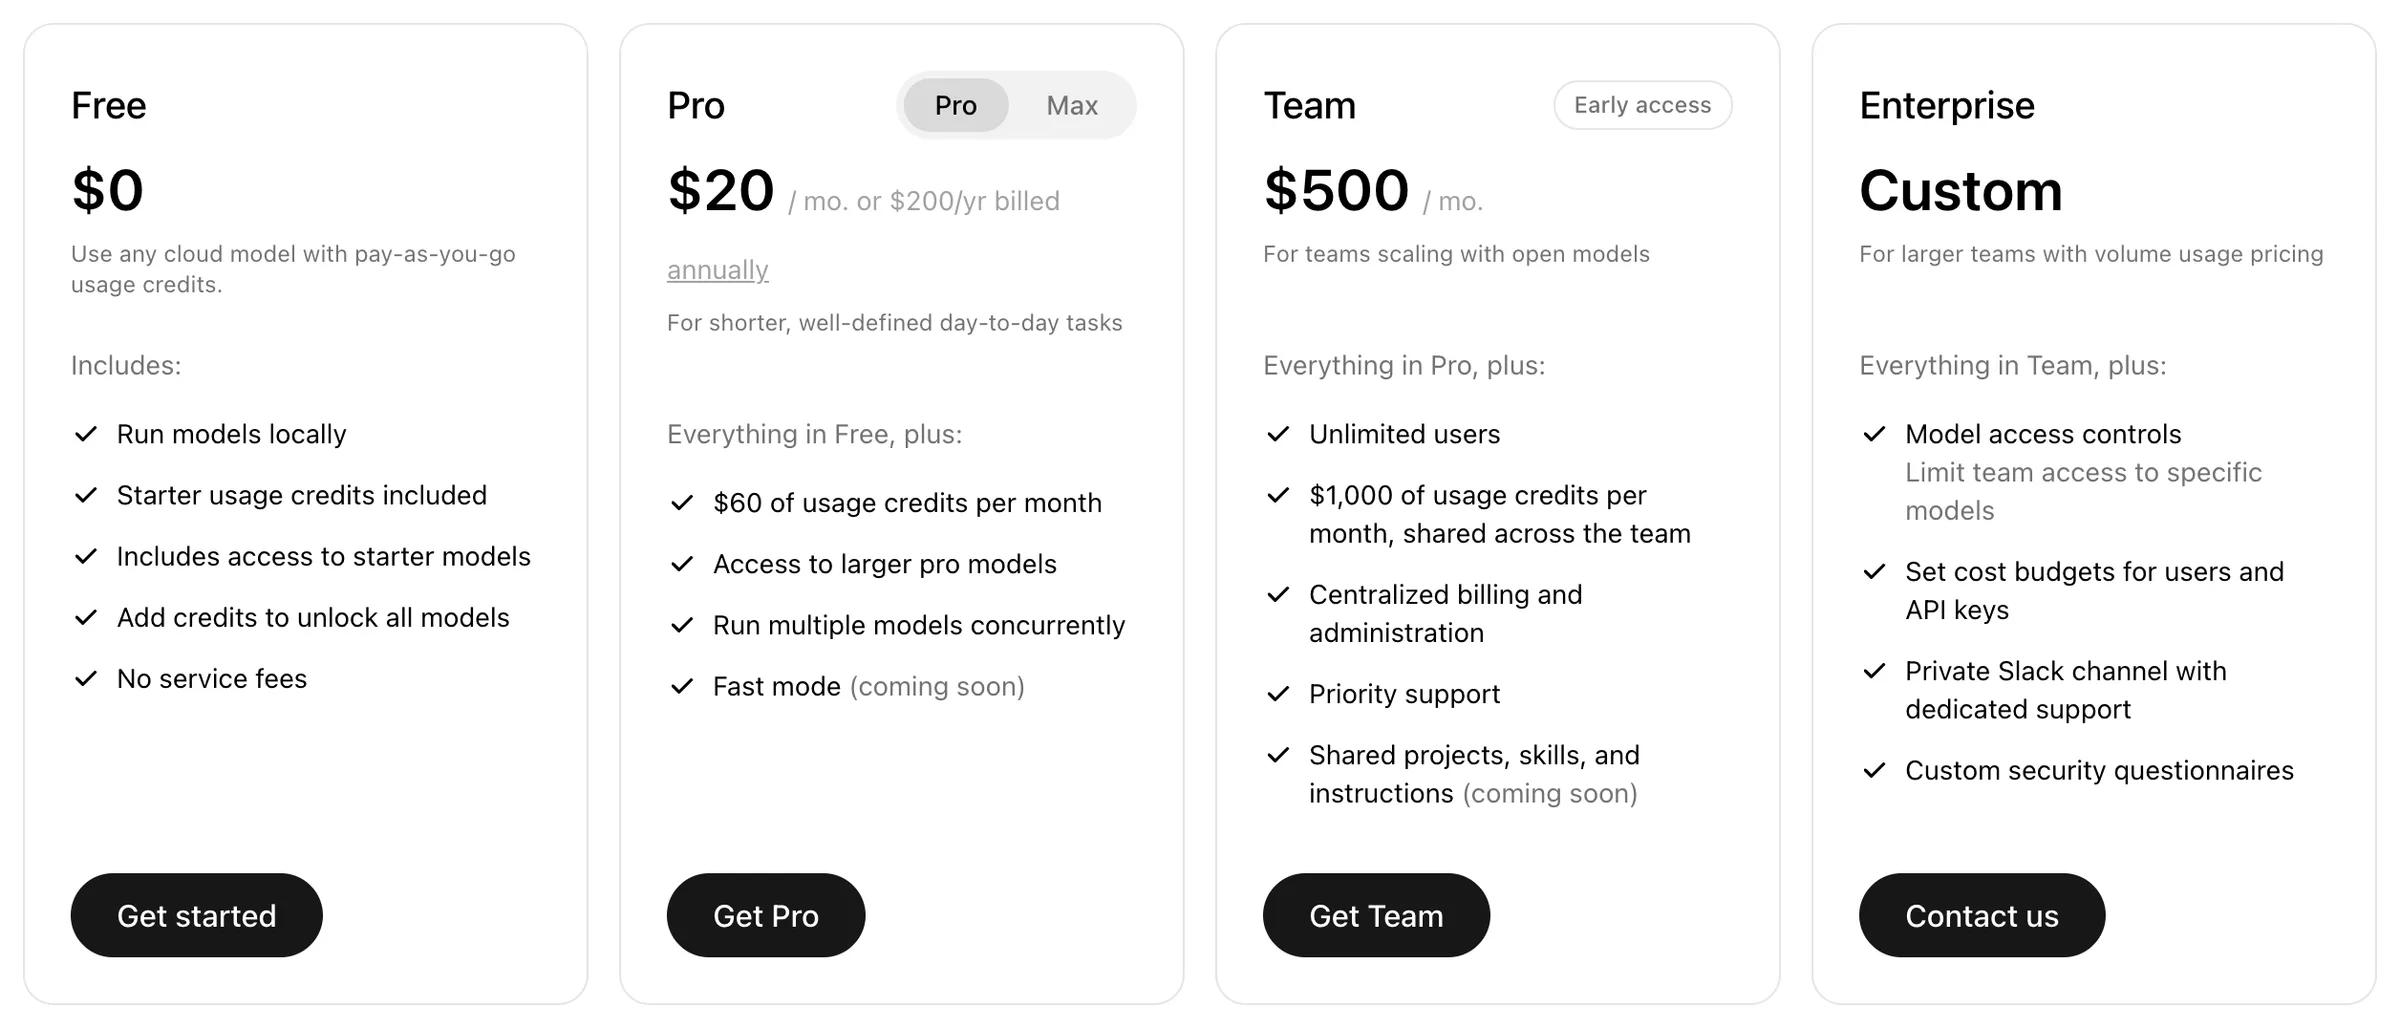
L'offre gratuite inclut des crédits d'usage de démarrage, d'un montant qu'Ollama ne publie pas, pour quelques modèles comme gemma4:cloud. Pro coûte 20 $ par mois (200 $ par an) avec 60 $ d'usage par mois, et Max 100 $ avec 300 $, d'après les tarifs d'Ollama. Ollama affirme ne pas stocker ni journaliser les prompts envoyés au cloud, ne jamais s'en servir pour l'entraînement, et héberger ses modèles principalement aux États-Unis. Pour un Claude Code gratuit avec Ollama et sans limite d'usage, restez donc sur un modèle local.
Ce qui quitte votre ordinateur
0 sur 5 faites
Dépanner Claude Code avec Ollama
La plupart des erreurs d'API de Claude Code avec Ollama viennent d'un Ollama arrêté ou occupé, d'un mauvais nom de modèle, d'un contexte trop petit ou d'un manque de mémoire.
| Ce que vous voyez | Ce que cela veut dire | Solution |
|---|---|---|
| Claude Code vous demande de vous connecter | Il n'a reçu aucun jeton avant de démarrer | Utilisez ollama launch claude, ou définissez ANTHROPIC_AUTH_TOKEN=ollama avant claude |
| Une erreur « Connection refused » ou « Unable to connect to API » | Ollama ne tourne pas | Ouvrez l'application Ollama (sur Linux, ollama serve), puis vérifiez avec ollama -v |
API Error: 404 ... model '...' not found | Modèle non téléchargé, mauvais nom, ou Claude Code a demandé un modèle Claude | Lancez ollama ls, puis ollama pull avec le nom exact ; en voie manuelle, définissez les quatre lignes de modèles |
La première réponse prend plusieurs minutes, ou API error · Retrying in 0s | Le modèle lit la longue requête d'ouverture de Claude Code, ou Ollama est encore occupé par une requête précédente | Patientez : Claude Code réessaie tout seul. Gardez Ollama à jour (les versions 0.33.1 et suivantes reprennent un démarrage interrompu) |
Il oublie votre demande, s'arrête trop tôt ou affiche no user query found in messages | Le contexte est trop petit, donc Ollama a coupé le début de la conversation | Réglez 64K, vérifiez ollama ps, puis tapez /clear |
model requires more system memory ... than is available, ou une répartition CPU/GPU dans ollama ps | Le modèle et son contexte ne tiennent pas dans la mémoire graphique | Choisissez un modèle plus petit ou un modèle cloud, et fermez les autres applications |
| « Invalid tool parameters » ou « Error editing file » encore et encore | Le modèle écrit des appels d'outils cassés | Utilisez un modèle recommandé à 64K et mettez Ollama à jour |
403 ... this model requires a subscription | Ce modèle cloud n'est pas inclus dans l'offre gratuite | Utilisez gemma4:cloud, achetez des crédits ou passez à une offre supérieure |
Les lignes sur la connexion suivent la documentation de dépannage des passerelles d'Anthropic ; pour le reste, le journal d'Ollama sur Mac se trouve dans ~/.ollama/logs/server.log.
D'autres façons de faire tourner Claude Code sur un modèle local
LM Studio
La version 0.4.1 a ajouté le même point d'accès au format d'Anthropic. Démarrez son serveur sur le port 1234 et faites pointer ANTHROPIC_BASE_URL dessus.
llama.cpp
Son llama-server parle lui aussi le format d'Anthropic et compte les tokens exactement, mais vous téléchargez les fichiers de modèle et le lancez vous-même.
OpenRouter
Du cloud, pas du local : les modèles gratuits s'arrêtent à 50 requêtes par jour, et OpenRouter ne garantit Claude Code qu'avec les modèles d'Anthropic.
Claude Desktop sur Mac
Le menu Apps de l'application Ollama peut connecter Claude Desktop aux modèles Ollama, et la déconnexion rétablit votre configuration.
Ces détails viennent de la documentation de LM Studio et de celle d'OpenRouter. Pour un agent conçu pour fonctionner avec n'importe quel modèle, lisez Claude Code vs OpenCode.
Petit test0 sur 3 correctes
Vous avez configuré Claude Code avec Ollama et il oublie sans cesse votre demande. Que vérifiez-vous en premier ?
Pas tout à fait.
La plupart des ordinateurs démarrent Ollama à 4K ou 32K tokens, et la seule requête d'ouverture de Claude Code faisait environ 20 000 tokens dans nos essais : une petite fenêtre se remplit vite, et Ollama coupe le début de la conversation.
Après avoir utilisé ollama launch claude, vous tapez simplement claude dans une nouvelle fenêtre. Quel modèle répond ?
Pas tout à fait.
Le lanceur ne définit ses variables que pour la session qu'il démarre et ne modifie aucun réglage de Claude Code.
Qui prend en charge l'utilisation de Claude Code sur des modèles autres que Claude ?
Pas tout à fait.
La documentation d'Anthropic indique qu'Anthropic ne prend pas en charge l'envoi de Claude Code vers des modèles non Claude ; Ollama documente et maintient l'intégration.
Que faire ensuite
Installez Ollama, réglez le contexte sur 64K et donnez notre petite tâche à qwen3.8:27b (ou à qwen3.5:4b sur un ordinateur plus modeste), sur une copie d'un vrai dossier. Chronométrez-la et vérifiez le résultat vous-même avant de lui confier davantage. Si l'écart avec Claude est trop grand pour votre travail, comparez les forfaits dans notre guide des prix et tarifs de Claude Code, et si vous voulez un parcours guidé à travers de vrais projets, la formation Claude Code est ouverte en accès anticipé.
Kit de test d'un modèle local pour Claude Code
Un choix de modèle selon votre mémoire, trois tâches chronométrées avec leurs critères de réussite, tous les réglages dans un tableau et les étapes pour revenir à Claude ou retirer Ollama.
Saisissez votre e-mail et la section complète s'ouvre ici. Vous recevez aussi une leçon gratuite de la formation.
Questions fréquentes
Faut-il un compte Claude pour utiliser Claude Code avec Ollama ?
Non. Quand ANTHROPIC_AUTH_TOKEN est défini avant le démarrage de Claude Code, ce que la commande ollama launch claude fait pour vous, Claude Code saute la connexion à Claude et envoie chaque requête à Ollama. Les fonctions qui demandent une connexion à claude.ai, comme Remote Control, les sessions cloud et la dictée vocale, ne sont pas disponibles dans cette session.
Claude Code fonctionne-t-il hors ligne avec Ollama ?
Avec un modèle local, oui : une fois Ollama et le modèle installés sur votre ordinateur, le modèle n'a besoin d'aucune connexion Internet. Claude Code essaie quand même de joindre Anthropic pour ses mises à jour et ses statistiques d'usage, sauf si vous définissez CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, et la recherche web ou la lecture d'une page web demandent une connexion.
Comment remettre Claude Code sur les modèles Claude ?
Lancez simplement claude dans une nouvelle fenêtre de terminal. ollama launch claude ne définit ses variables que pour la session qu'il démarre, donc votre forfait Claude n'est pas touché ; si vous avez exporté les variables vous-même, fermez cette fenêtre ou retirez-les du profil de votre shell.
Peut-on utiliser Claude Code avec Ollama dans VS Code ?
Oui. Placez les mêmes variables (ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN et les noms de modèles) dans claudeCode.environmentVariables, dans les réglages utilisateur de VS Code, puis redémarrez le panneau Claude Code. L'extension VS Code d'Ollama est autre chose : elle ajoute les modèles Ollama au chat intégré de VS Code.
Peut-on utiliser les modèles Ollama dans l'application de bureau Claude ?
Sur Mac, oui : ouvrez l'application Ollama, choisissez Apps et connectez Claude, et Ollama configure Claude Desktop pour qu'il utilise ses modèles ; la déconnexion rétablit votre configuration habituelle. Ollama annonce la prise en charge de Windows pour bientôt.
À lire aussi
Claude Code vs OpenCode : coût, modèles et confidentialité
Claude Code vs OpenCode, vérifié en octobre 2026 : benchmarks, vrais coûts, pourquoi Claude Pro ne marche pas dans OpenCode, modèles locaux, confidentialité.
Claude Code · 13 min de lectureClaude Code prix et tarifs 2026 : Pro vs Max, Team et API
Claude Code prix et abonnements vérifiés en octobre 2026 : est-il gratuit, Pro vs Max, Team, Enterprise, coût de l'API au token et quel forfait choisir.
Claude Code · 17 min de lectureInstaller Claude Code sur Mac et Windows en 3 étapes (2026)
Installation de Claude Code sur Mac ou Windows : l'installateur officiel en 3 étapes, l'option sans terminal, la connexion et les erreurs les plus courantes.
Claude Code · 18 min de lecture